Spanning Tree
My vault 演算法筆記:Spanning Tree。
Spanning Tree Concept
定義(Definition)
對一個連通無向圖 $G=(V,E)$:
-
若 $G$ 是連通的(connected),則它至少存在一棵生成樹(spanning tree)。
-
生成樹是指:
$$
T = (V, E_T) \subseteq G
$$ -
==其中 $T$ 含有所有頂點($|V|$ 相同),但邊數為 $|E_T| = |V|-1$,而且沒有環(acyclic)。==
性質(Properties)
-
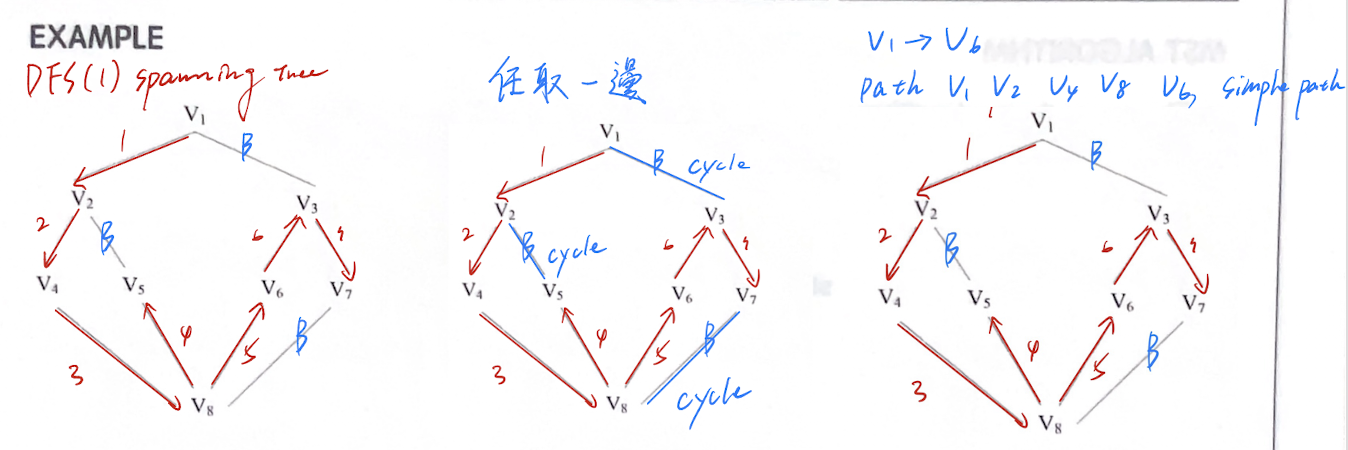
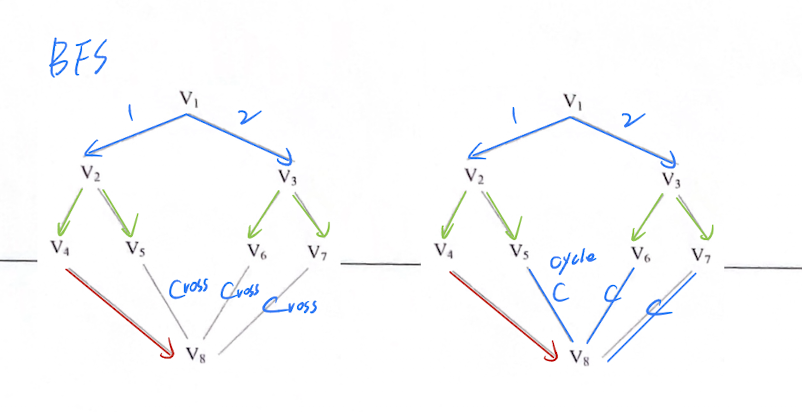
DFS 或 BFS 的樹邊(Tree Edge)會構成一棵生成樹。
- ==若圖是連通的,執行 DFS/BFS 會拜訪所有頂點,因此這些 traversal 形成的樹就是 spanning tree==。
-
在任何連通圖中:
-
若加入任何一條不屬於生成樹的邊,會產生一個簡單環(simple cycle)。
-
若刪除生成樹中任一條邊,會使圖變成不連通==(生成兩個 component)==。
-
圖形例子
圖 $G$ 有頂點 ${A, B, C, D, E}$,邊為多重連接(例如 $A$–$B$, $A$–$C$, $B$–$C$, $B$–$D$, $C$–$E$, $D$–$E$ 等)。
你右邊畫的:
-
$S_1$ 和 $S_2$ 各是 $G$ 的不同生成樹。
-
$S_1$:$A$–$B$, $A$–$D$, $B$–$C$, $C$–$E$
-
$S_2$:$A$–$B$, $B$–$C$, $C$–$E$, $E$–$D$
-
-
兩者都有 5 個頂點和 4 條邊($|V|-1=4$),所以都符合生成樹條件。
-
最後一句「$S_1$ and $S_2$ 是不同但同屬生成樹」是在說這圖有多個可能的 spanning tree。
DFS 與 BFS 生成樹的差異
-
DFS Spanning Tree:偏向「深」的結構,每次盡量往下走到底。
-
BFS Spanning Tree:偏向「廣」的結構,按層次展開。
-
兩者都能構成生成樹,但邊的選取順序不同。
Minimum spanning tree(MST)
-
定義 在連通、無向、帶權圖 $G=(V,E,w)$ 中,生成樹 $T=(V,E_T)$ 使得 $\sum_{e\in E_T} w(e)$ 最小者稱為 MST(可能不唯一)。
-
關鍵事實
-
$|E_T|=|V|-1$、連通、無環。
-
若 $G$ 不連通,無 MST;只能談各分量的 Minimum Spanning Forest。
-
權重全互異 ⇒ MST 唯一;若存在相同權重 ⇒ 可能多棵但總權重相同。
-
Cut 性質:對任意切割 $(S,V\setminus S)$,跨越切割的最輕邊 $e$ 屬於某棵 MST。
-
Cycle 性質:任一環中最重邊不屬於任何 MST。
-
-
常用演算法
-
Kruskal:邊依權重遞增排序,掃描加邊且避免成環(並查集判環)。時間 $O(E\log E)$。
-
Prim:由任一起點擴張,每次選跨越當前切割的最小權重邊。用最小堆時時間 $O(E\log V)$(或以 Fibonacci 堆可至 $O(E+V\log V)$)。
-
-
直覺 要連到 $n$ 個點至少需要 $n-1$ 條邊;MST 是在所有可行的 $n-1$ 邊組合中,使 $\sum_{e\in E_T} w(e)$ 最小的那組。
定理
如果 Graph 所有邊成本不同,那麼 MST 唯一
-
假設有兩棵樹 (A, B):我們先假設有兩棵不同的最小生成樹 A 和 B。
-
找到最便宜的差異邊 (e1):找出在 A 和 B 之間所有不同的邊,並從中選出成本最小的那條,稱為
e1。假設e1在 A 裡面,但不在 B 裡面。 -
把 e1 加到 B 製造循環:將
e1加入到樹 B 中,這必然會產生一個循環。 -
找到另一條差異邊 (e2):在這個循環中,必定存在另一條邊
e2,它不在樹 A 裡面。 -
成本比較 (e1 < e2):因為
e1是所有差異邊中最便宜的,所以e1的成本必定小於e2。 -
替換 e2 得到更優的樹:我們在 B 中移除較貴的
e2,換成較便宜的e1,得到一棵新的生成樹B'。這棵新樹的總成本必定比 B 還要低。 -
產生矛盾:我們找到了一棵比 B 更便宜的樹
B',這與我們一開始「B 是最小生成樹」的假設互相矛盾。
Cut Theory
核心思想: 提供一個明確的規則,告訴我們如何找到一條可以安全加入 (include) 最小生成樹的邊,其實也是在證明 cut-set 中的最小成本邊一定會在 All MSTs 中。
這個理論的運作基於以下步驟:
-
進行一次「切割」(Cut):將圖上的所有頂點任意分成兩堆,稱為
S和V-S。 -
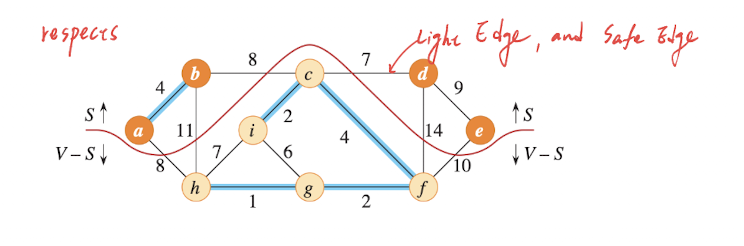
切割必須「尊重」(Respect) A:這個切割的劃分方式,不能切斷任何一條我們已經選入集合
A的邊。在圖Figure 21.2中,切割是按頂點顏色劃分的,而所有藍色的邊 (集合 A) 都沒有橫跨這個切割,所以這個切割尊重 A。 -
找到「輕邊」(Light Edge):在所有橫跨這兩堆的邊中,找出權重最輕的那一條。
-
結論:這條最輕的跨界邊,就是一條**「安全邊」(safe edge)**,可以被無誤地加入到我們的最小生成樹中。
證明邏輯 (剪貼法):其證明是透過反證法。假設這條最輕的跨界邊 (u, v) 不在某個 MST T 中,那麼在 T 裡必定存在另一條路徑可以連接 u 和 v,且該路徑上必定有另一條更重的跨界邊 (x, y)。我們可以從 T 中移除 (x, y) 並加入 (u, v),得到一棵總權重更小的新生成樹 T',這與 T 是 MST 的假設矛盾。
Cycle Theory
核心思想: 提供一個明確的規則,告訴我們哪一條邊絕對不能 (cannot belong) 屬於最小生成樹,因此可以被安全地排除 (exclude)。
這個理論的運作基於以下步驟:
-
找到一個「循環」(Cycle):在圖中識別出任何一個閉合的環路。
-
找到最重的邊:在這個循環包含的所有邊中,找出權重最大的那一條邊
e。 -
結論:這條權重最大的邊
e,絕對不會出現在任何一個最小生成樹中。
證明邏輯 (替換法):同樣採用反證法。假設這條最重的邊 $e$ 存在於某個 MST $T$ 中。如果我們將 $e$ 移除,樹會斷開。但因為 $e$ 在一個循環中,我們必然可以在該循環中找到另一條權重更輕的邊 $W$ 來重新連接樹。這樣操作後得到的新生成樹 $S$,其總權重必定小於 $T$,這與 $T$ 是 MST 的假設矛盾。
- ==Q1:在圖 $G$ 中最大邊必定不在 MST 中?False==
- ==Q2:在圖 $G$ 的 cycle 的最小成本一定在 MST 中? False==
總結比較表
| 特性 (Feature) | 切割理論 (Cut Theory) | 循環理論 (Cycle Theory) |
|---|---|---|
| 核心目標 | 識別可以加入的安全邊 (Inclusion) | 識別必須排除的非安全邊 (Exclusion) |
| 關鍵結構 | 切割 (Cut):將頂點分為兩堆 | 循環 (Cycle):圖中的一個閉合環路 |
| 尋找對象 | 權重最輕的跨界邊 (Lightest edge crossing the cut) | 權重最重的循環邊 (Heaviest edge in the cycle) |
| 理論來源 | CLRS Theorem 21.1 & PPT | PPT |
| 主要應用演算法 | Prim’s Algorithm (每次都將已選頂點視為一堆,未選的為另一堆) | Kruskal’s Algorithm (當加入一條邊會形成循環時,該邊必為循環中最重的邊,因此捨棄) |
Kruskal’s Algorithm
-
輸入:連通無向帶權圖 $G=(V,E,w)$
-
輸出:MST 的邊集合 $T$
-
一些直得注意的
-
單次均攤 Find/Union 為 $Θ(\alpha(|V|))$。
-
權重可為負;權重並列時 MST 可能不唯一。
-
稀疏圖常選 Kruskal’s;稠密圖多用 Prim’s。
-
==步驟==
-
$T\leftarrow\varnothing$;為每個頂點建立一個集合(Disjoint Set)。
-
依權重遞增排序所有邊(或用最小堆)。
-
依序取邊 $(u,v)$:
-
若 Find(u) ≠ Find(v)(不成環),將 $(u,v)$ 加入 $T$,並 Union(u,v)。
-
否則丟棄 $(u,v)$。
-
-
當 $|T|=|V|-1$ 時停止。
-
若掃完仍 $|T|<|V|-1$,圖不連通,無 MST(得到最小生成森林)。
正確性要點
-
Cut 性質:跨任一切割的最輕邊必屬某棵 MST。
-
遞增挑邊且避環 ⇒ 每步皆選安全邊。
複雜度
-
排序:$O(E\log E)$。
-
並查集 Find/Union:總 $O(E\cdot \alpha(|V|))$。
-
總時間:$O(E\log E)$(因為 $E\log E \ge E\cdot\alpha(|V|)$)。
-
空間:$O(|V|)$(並查集)或 $O(|V|+E)$(含堆)。
手寫範例
[!note]- 手寫範例
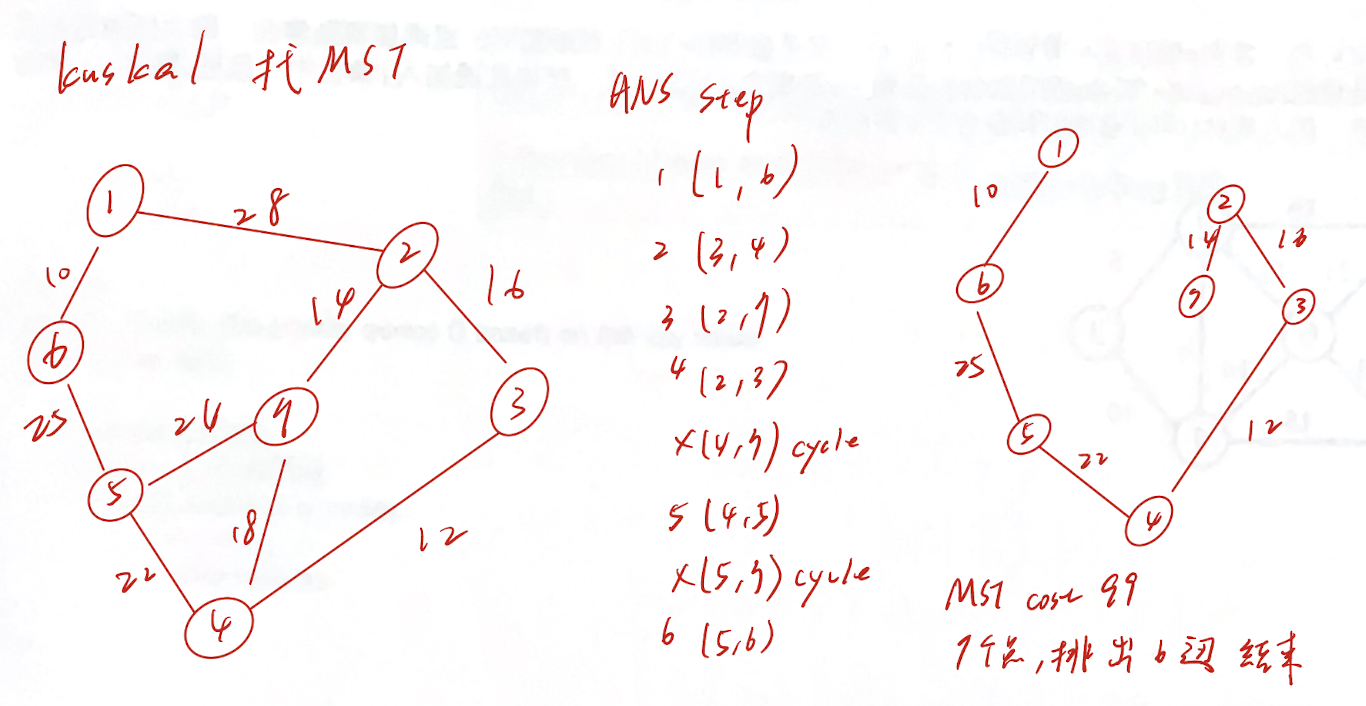
實作(Like C)
CLRS 版(先整體排序)
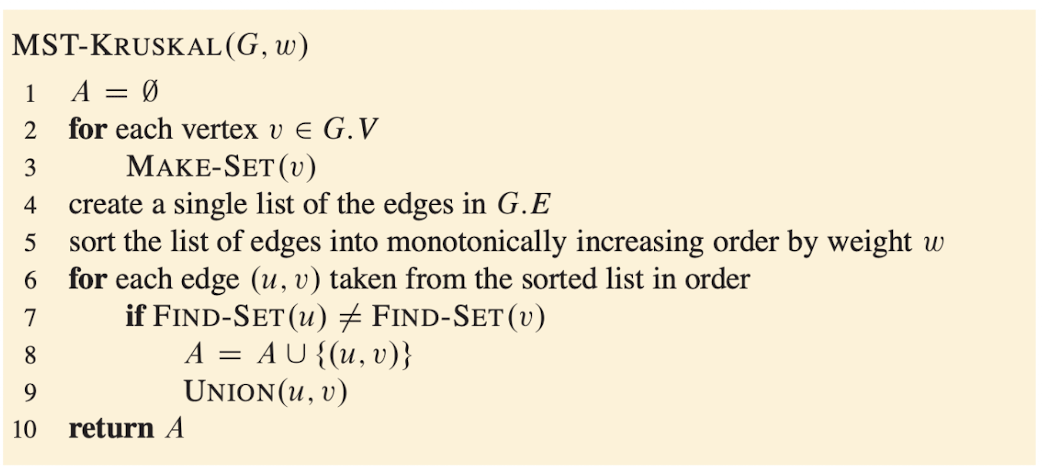
typedef struct { int u, v, w; } Edge;

int kruskal_clrs(int V, int E, Edge edges[], Edge T_out[]){
    sort_edges_by_w(edges, E);              // O(E log E)
    DSU d[V]; dsu_init(d, V);
    int t = 0;
    for(int i=0;i<E && t<V-1;i++){
        int u = edges[i].u, v = edges[i].v;
        if(dsu_find(d,u) != dsu_find(d,v)){ // ~ O(α(V))
            T_out[t++] = edges[i];
            dsu_union(d,u,v);
        }
    }
    return (t==V-1) ? t : -1;               // -1 表不連通
}
DS 版(以最小堆逐邊取出)
typedef struct { int u, v, w; } Edge;
typedef struct { Edge *a; int n; } MinHeap;

void  heap_push(MinHeap *h, Edge e);  // O(log E)
Edge  heap_pop (MinHeap *h);          // O(log E)
MinHeap build_min_heap(Edge a[], int n); // O(E)

int kruskal_heap(int V, int E, Edge edges[], Edge T_out[]){
    MinHeap H = build_min_heap(edges, E);  // O(E)
    DSU d[V]; dsu_init(d, V);
    int t = 0;
    while(H.n && t<V-1){
        Edge e = heap_pop(&H);             // 目前最小邊
        if(dsu_find(d,e.u) != dsu_find(d,e.v)){
            T_out[t++] = e;
            dsu_union(d,e.u,e.v);
        }
    }
    return (t==V-1) ? t : -1;
}
Kruskal’s Algorithm 時間分析(依 CLRS)
前置假設:並使用 union-by-rank + path compression。其均攤成本為 $Θ(\alpha(|V|))$。
成本分解
-
初始化 A 與建單一邊表
-
建空集合 $A$:$O(1)$。
-
將圖的邊收集成單一串列:$O(V+E)$;對連通圖視為 $O(E)$。
-
-
排序所有邊
- 以權重升冪排序邊表:$O(E\log E)$。 這是主導項之一。
-
並查集操作
-
$|V|$ 次
MAKE-SET:$O(|V|)$。 -
在主迴圈對每條邊執行一次
FIND/UNION:總 $O(E,\alpha(|V|))$。 -
合計並查集成本:$O((V+E)\alpha(|V|))$;連通圖下可視為 $O(E,\alpha(|V|))$。
-
合併與化簡
總時間
$$
T(E,V)=O(E\log E)+O(E,\alpha(|V|))+O(E)
=O(E\log E)
$$
理由:$\alpha(|V|)$ 成長極慢,且對連通圖有 $|E|\ge |V|-1$,並且 $\alpha(|V|)=O(\log |V|)=O(\log |E|)$,因此 $E\log E$ 主導。
同階改寫
因為 $|E|<|V|^2$,有 $\log |E|=O(\log |V|)$,故亦可寫
$$
T(E,V)=O(E\log V),.
$$
空間:並查集 $O(|V|)$;若含邊表/堆則 $O(|V|+E)$。
Prim’s Algorithm
核心 維持集合 $S$(已在樹內)。每步選跨越切割 $(S, V\setminus S)$ 的最小權重邊,把對端頂點加入 $S$。安全性由 Cut 性質保證。
DS 版(鄰接矩陣,無堆,$O(V^2)$)
適合稠密圖或教學。
// n: 頂點數,w[i][j]: 權重(無邊設 INF),r: 起點
void prim_matrix(int n, int r){
    int inS[n]; for(int i=0;i<n;i++) inS[i]=0;
    int key[n]; for(int i=0;i<n;i++) key[i]=INF;
    int parent[n]; for(int i=0;i<n;i++) parent[i]=-1;

    key[r]=0;
    for(int it=0; it<n; it++){
        // 取不在 S 且 key 最小者 u
        int u=-1;
        for(int v=0; v<n; v++)
            if(!inS[v] && (u==-1 || key[v]<key[u])) u=v;
        inS[u]=1;

        // 用 u 鬆弛鄰點
        for(int v=0; v<n; v++)
            if(!inS[v] && w[u][v] < key[v]){
                key[v]=w[u][v];
                parent[v]=u;
            }
    }
    // (parent[v], v) 即為 MST 邊
}
時間:選最小 u 共 $V$ 次,各次掃一列 $V$,總 $O(V2)$。空間 $O(V2)$。
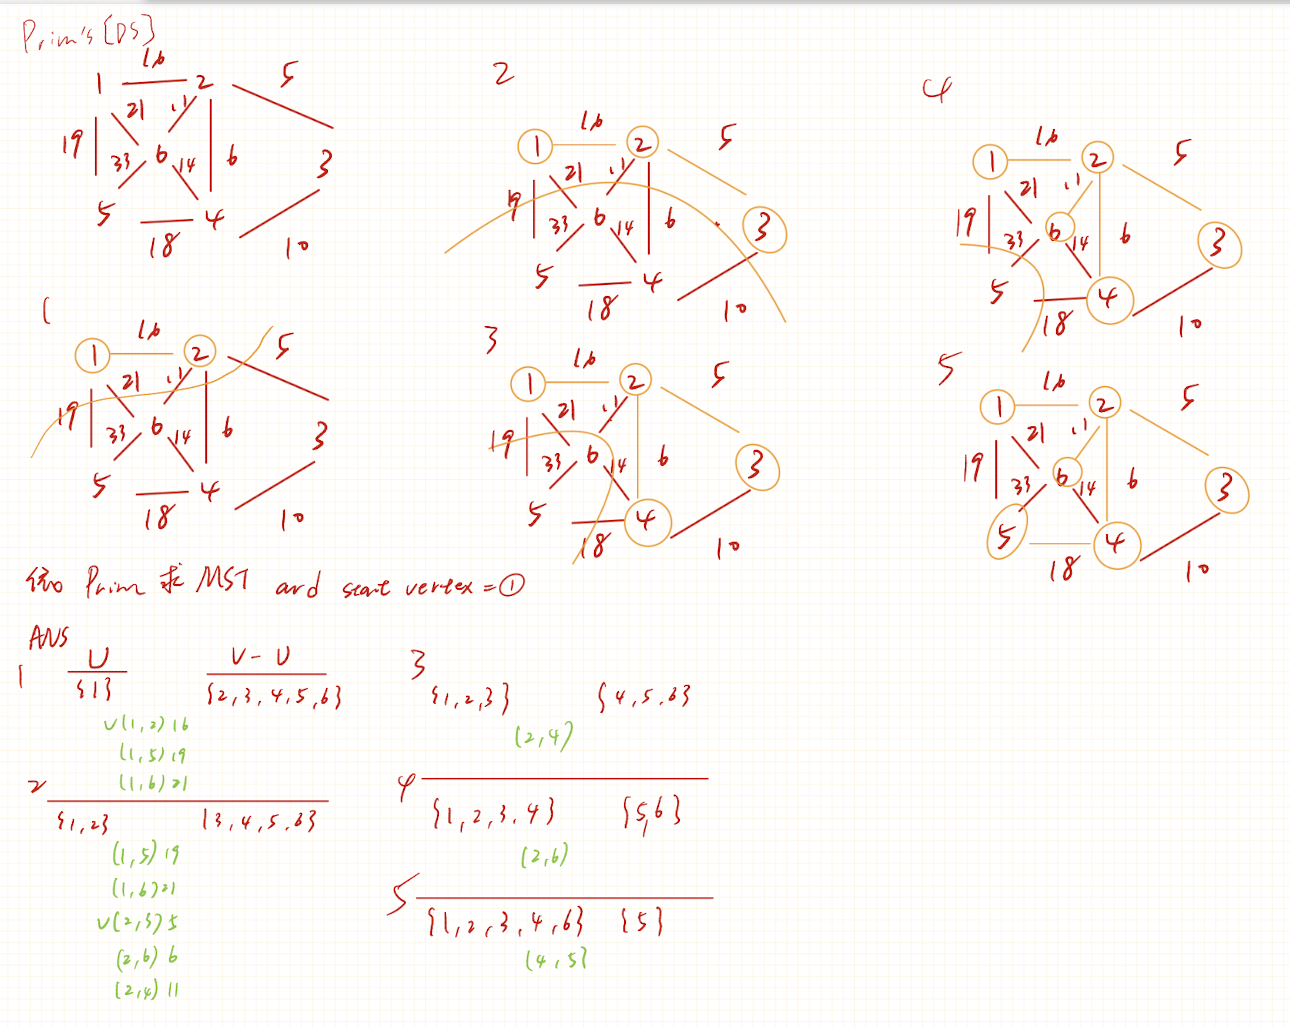
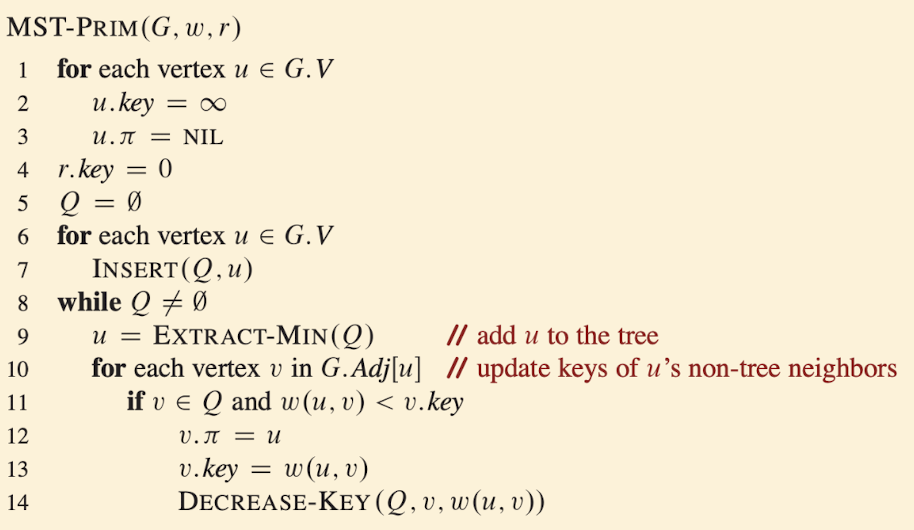
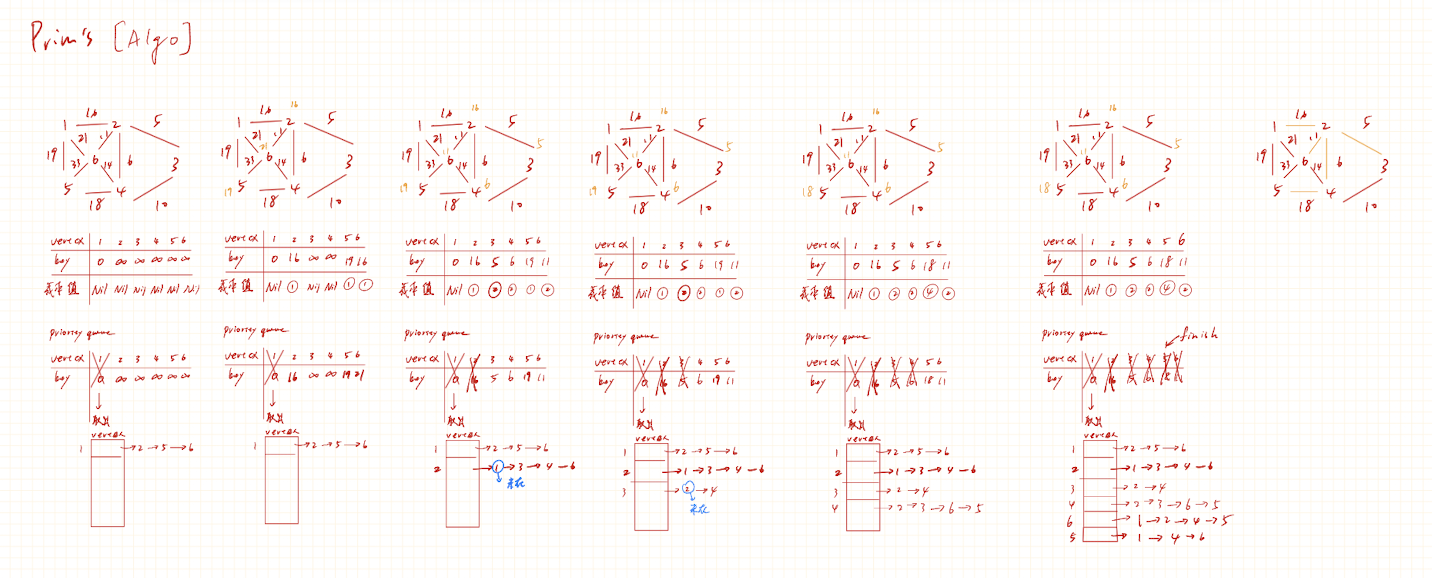
CLRS 版(鄰接表 + 最小堆,O($E\log V$))
適合稀疏圖與實作,也是使用鬆弛這個方式也就是說找到新路近看有沒有連到如果有就更新如果更小的話 (relaxation)。
// n: 頂點數,root: 起點(0..n-1)
// 回傳總權重;parent[v] 可重建 MST
int prim_clrs(int n, int root, int parent[]){
    static int key[MAXV];              // 依需要改為動態配置
    for(int i=0;i<n;i++){ key[i]=INF; parent[i]=-1; pos[i]=-1; }
    key[root]=0;

    heap_build(n, key);                // O(V)
    int total=0;

    while(!heap_empty()){
        HNode hn = heap_pop();         // 取當前最小 key 的頂點 u
        int u = hn.v;
        if(hn.key==INF) return -1;     // 不連通(得到森林)
        total += hn.key;

        for(int e=head[u]; e!=-1; e=g[e].next){
            int v=g[e].to, w=g[e].w;
            if(pos[v]!=-1 && w<key[v]){   // v 仍在堆中且可鬆弛
                key[v]=w;
                parent[v]=u;
                heap_decreaseKey(v, w);   // O(log V)
            }
        }
    }
    return total;
}
時間:每個頂點一次 extract-min($O(\log V)$),每條邊最多一次 decrease-key($O(\log V)$),總 $O(E\log V)$。空間 $O(V+E)$。
若用 Fibonacci heap:$O(E + V\log V)$。
複雜度對照
-
鄰接矩陣:$O(V^2)$
-
鄰接表 + 二元堆:$O(E\log V)$
-
鄰接表 + Fibonacci 堆:$O(E + V\log V)$
備忘
-
權重可為負。連通性必須成立;否則得到最小生成森林。
-
輸出邊集可由
parent[v]重建;總權重為 $\sum_{v\ne r} w(parent[v],v)$。 -
Prim 與 Kruskal 皆以 Cut 性質為正確性基礎;Prim 是單棵樹擴張,Kruskal 是合併多樹。
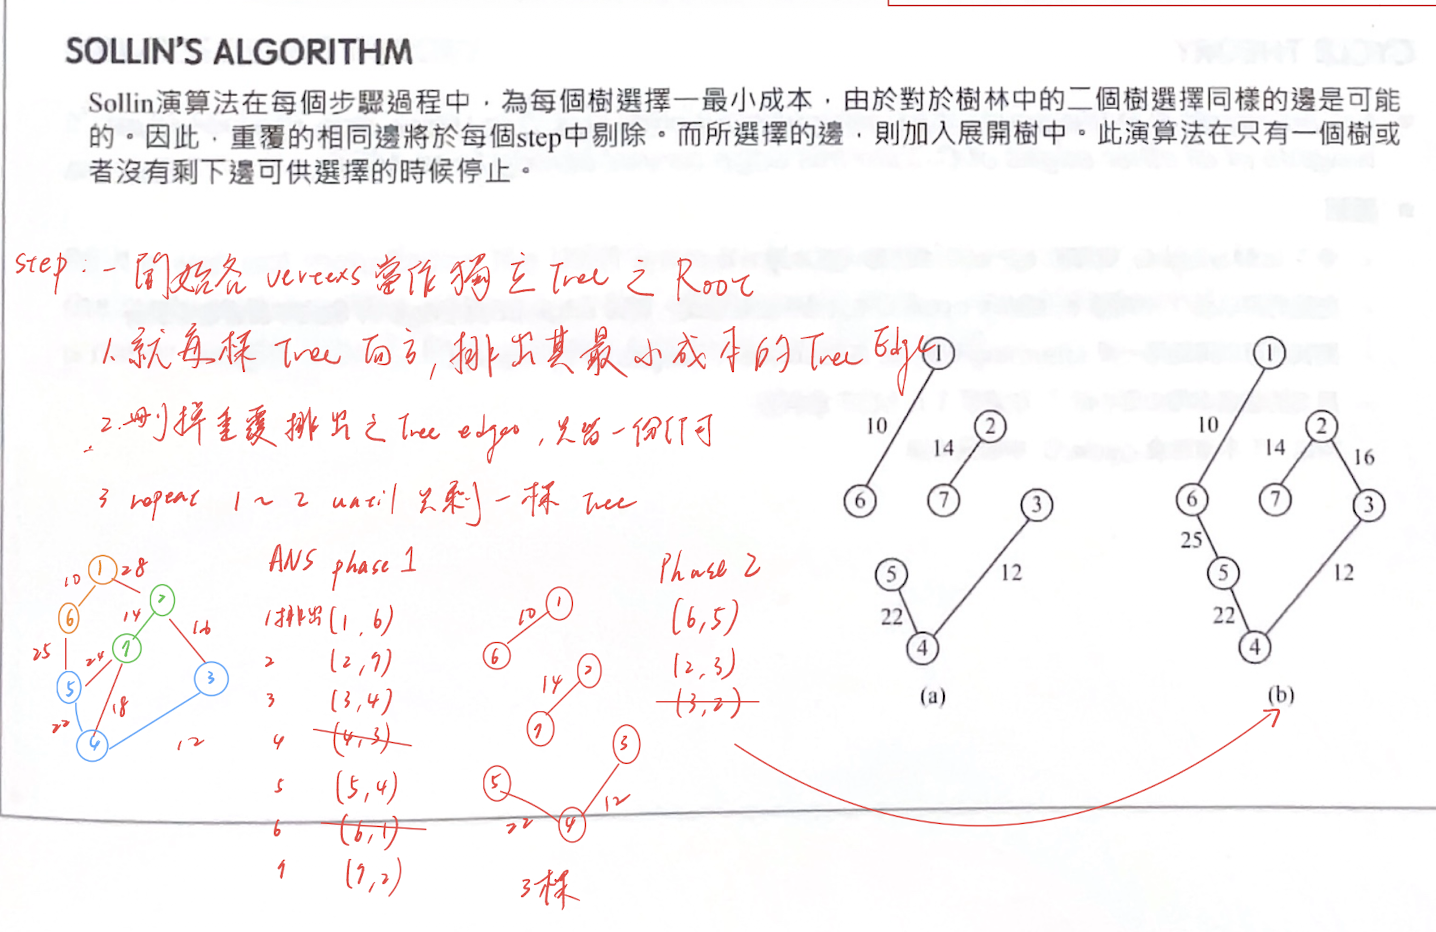
Sollin’s Algorithm