LSM-Tree:MemTable、SSTable 與 Compaction
LSM-Tree:MemTable、SSTable 與 Compaction的重點整理。
LSM-Tree(Log-Structured Merge-Tree)
TL;DR
LSM-Tree 先在記憶體累積更新,再批次寫出不可變的 SSTables;查詢整合各來源的有效版本,背景則透過 Compaction 整理檔案與回收過時資料。
- 寫入與 Flush:Active MemTable 接收更新,切換後的新 MemTable 繼續接收寫入,舊表在 Flush 完成前仍可查詢。WAL 支援故障恢復;Skip List 是維護 MemTable 有序資料的一種實作。
- 讀取與版本整合:Merge-Iteration 按 Key 順序走訪多個來源,再依版本、可見性與 Tombstone 規則產生有效結果;讀取不必等待 Compaction 完成。
- 合併策略:Leveled 依層級容量等門檻挑選檔案,與下一層範圍重疊的資料合併;Size-Tiered 則將大小相近的檔案分組整理。Level 沒有固定的 Key 範圍。
- 舊資料回收:Compaction 建立新的 SSTables 與索引,略過可安全清除的舊版本與 Tombstones;仍須滿足快照、底層舊值與副本等保留條件,舊檔案也要等讀者不再需要時才能回收。
- 讀寫與空間取捨:Bloom Filter 排除不必要的 Key 查找,Secondary Index 改善非主鍵欄位查詢,Compression 減少資料占用;這些設計也帶來記憶體、維護或 CPU 成本,不能只看單一放大指標。
常見 SSTable 實作的基本流程
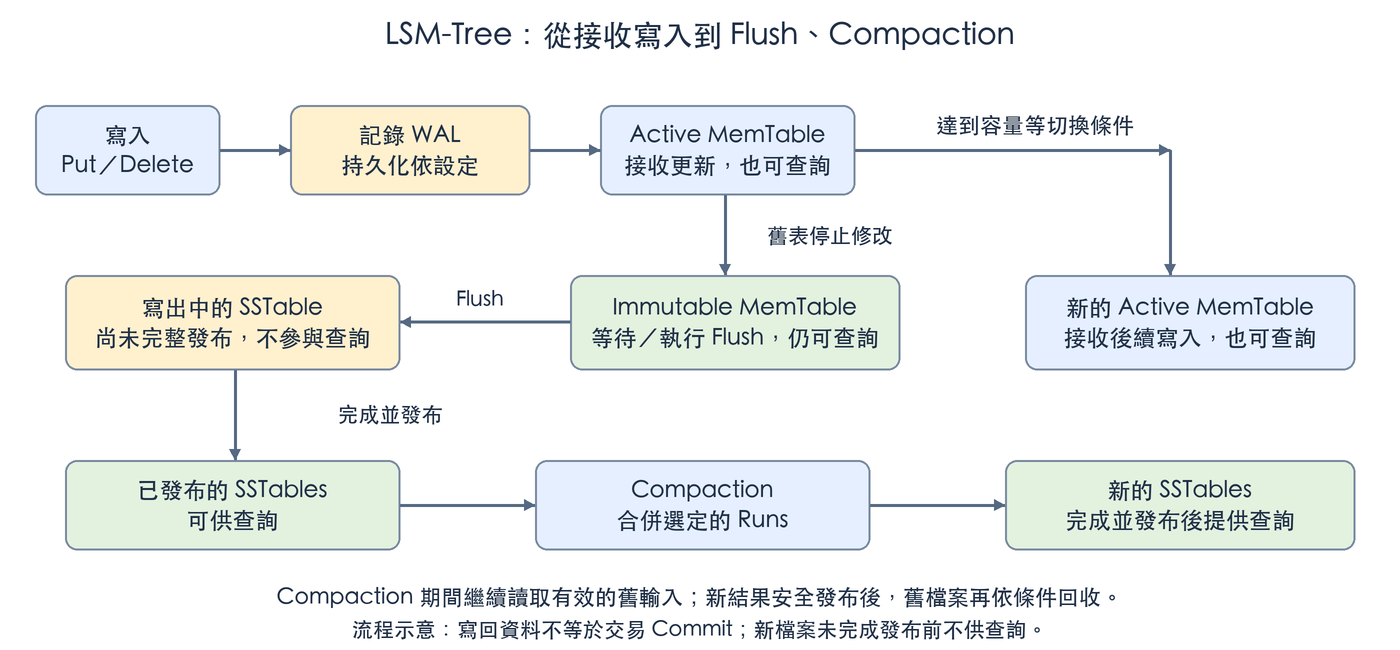
圖中區分新舊 MemTable 與磁碟檔案:切換後的新寫入進入新 MemTable,舊 MemTable 在 Flush 完成前仍可查詢;尚未完成發布的輸出檔案不參與讀取。
LSM-Tree 由較小的記憶體元件 MemTable,以及較大的磁碟元件組成。在常見實作中, Active MemTable 是可變的,用來接收更新並支援查詢;達到設定的容量門檻後,通常會轉為 Immutable MemTable,新的更新則由另一個 Active MemTable 接收。
舊 MemTable 透過 Flush,將內容依 Key 順序寫入磁碟,形成不可變的 Sorted Run,常以 SSTable 檔案儲存;Flush 完成前,查詢仍須考慮尚在記憶體中的 Immutable MemTable。後續再透過 Compaction 合併磁碟上的 Runs,產生新檔案,而不是原地修改既有檔案。
以下依 LevelDB 官方實作說明 整理常見流程,具體格式與合併政策依實作而異。
- 接收更新:將更新記錄在 WAL,並放入記憶體中的 MemTable;日誌是否同步持久化依寫入選項而定。
- Flush:MemTable 切換後,將舊 MemTable 的有序內容寫成不可變的 SSTable,後續寫入改由新的 MemTable 接收。
- 查詢與版本判斷:讀取必須考慮記憶體中的更新與磁碟上的 SSTables,依版本及刪除標記判斷有效結果。
- Compaction:合併選定的有序檔案,產生新檔案;確認版本與刪除標記已可安全清理後,才移除不再需要的內容。
Flush 是把記憶體資料寫出;Compaction 則整理既有的有序資料。它們與交易 Commit 的關係需要依引擎的持久化設計分開理解。WAL、提交與當機恢復的關係,見 Database Internals。
Skip List:MemTable 如何維持有序?
MemTable 不只是暫存寫入,也要支援依 Key 查找與有序走訪。常見實作之一是 Skip List(跳躍串列):底層保留完整的有序串列,上方用較稀疏的連結跨過多個節點;查找時先沿高層前進,再逐層往下縮小範圍。隨機化 Skip List 的查找與插入具有預期 \(O(\log n)\) 成本,並能沿底層依序讀出資料,供 Iterator 與 Flush 使用。
例如先寫入 Key 35,再寫入 15、25,Skip List 會依比較規則維持 15、25、35 的走訪順序,而不是單純照插入時間排隊。以 LevelDB 為例,MemTable 內部以 Skip List 保存包含版本與操作類型的 Internal Keys。MemTable 切換為 Immutable 後,停止接收更新,但仍可用相同結構提供查詢,直到 Flush 完成後安全回收。參考 LevelDB:MemTable。
Skip List 是 MemTable 的一種實作選擇,不是所有 LSM-Tree 的必要規格;它管理記憶體中的有序紀錄,Bloom Filter 則排除不含目標 Key 的來源,Secondary Index 則支援另一個欄位的查找路徑。
圖例:查找 7 與插入 6
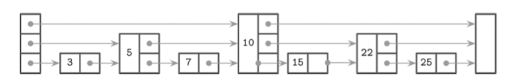
圖中底層依序為 3、5、7、10、15、22、25;5、22 有中層連結,10 還有最高層連結。同一個節點可以保存多個層級的下一個指標,不是每一層都複製一份資料。例如 5 的底層指標通往 7,中層指標則跨過 7、通往 10。這些層級是記憶體中的快速連結,與 LSM 的 L0、L1、L2 檔案分層不同。
查找 7:下一個 Key 太大,就留在目前節點往下一層找。
| 步驟 | 目前位置 | 查看下一個 Key | 動作 |
|---|---|---|---|
| 1 | Head,最高層 | 10 | 10 大於 7,不前進;從 Head 降一層 |
| 2 | Head,中層 | 5 | 5 小於 7,前進到 5 |
| 3 | 5,中層 | 10 | 10 大於 7,不前進;留在 5,降到底層 |
| 4 | 5,底層 | 7 | 找到目標 |
這裡先查看下一個節點的 Key,判斷能否前進;不是一定要走到 10,再退回前驅。
插入 6:先找位置,再接好新節點的指標。沿相同方法搜尋,找到底層的 5 與 7 之間;假設隨機決定 6 有兩層,則需要更新:
| 層級 | 插入前 | 插入後 |
|---|---|---|
| 底層 | 5 → 7 | 5 → 6 → 7 |
| 中層 | 5 → 10 | 5 → 6 → 10 |
| 最高層 | Head → 10 | 保持原樣 |
新節點指向各層對應的後繼,再讓前驅接到新節點;不需要像平衡搜尋樹那樣進行旋轉。隨機高度讓高層節點較少、低層節點較多,用較稀疏的連結跳過一段資料。
並行插入時,多層連結需要分步接好。書中介紹的一種方案使用 fully_linked 標記區分節點是否已完成連結,配合發布規則,讓操作對外看起來像在某個瞬間完整生效,也就是線性化的概念;實際生效點與同步方式依演算法而定,不是所有 Skip List 都使用同一個標記。
Two-component LSM-Tree:記憶體樹與磁碟樹的分批合併
Two-component LSM-Tree 由較小的記憶體元件 \(C_0\) 與較大的磁碟元件 \(C_1\) 組成。\(C_0\) 累積更新;書中這個模型的 \(C_1\) 則以 B-Tree 類型的結構組織,磁碟頁面不直接原地覆寫,但整棵磁碟樹仍會隨合併更新。
Flush/合併時,系統分批取出記憶體樹中的部分資料,與磁碟樹對應 Key 範圍的內容按序合併,再將結果寫到新的磁碟位置。接著更新樹的導航,使查詢能找到合併後的新內容,並移除已遷移的記憶體資料。原論文將這種逐步推進的合併稱為 Rolling Merge;不必每次重寫整棵磁碟樹。
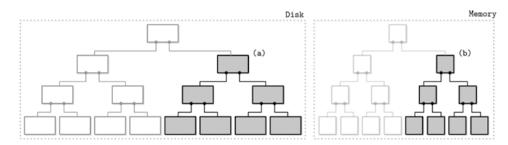
圖中(a)標出磁碟樹待合併的部分,(b)標出記憶體樹中對應範圍的資料;兩者按 Key 順序合併,未涉及的磁碟子樹可以保留。
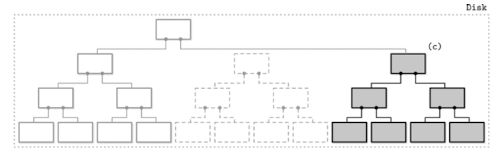
圖中(c)是寫到新位置、重新接回磁碟樹的合併結果;中間虛線描繪被取代的舊部分。這裡改變的是該範圍的子樹,不是把整棵磁碟樹重新寫一遍。
這與前面「整份 MemTable 凍結後寫成新 SSTable」的流程不同。Rolling Merge 可以持續從 \(C_0\) 分批移出資料,不要求每次都切換整份 MemTable;若實作採用 Active/Immutable MemTable 切換,新寫入才由另一份 Active MemTable 接收。
合併期間需要維持三件事:
- 新寫入有明確的接收位置:採 MemTable 切換時寫入新的 Active MemTable;分批 Rolling Merge 則須協調 \(C_0\) 中的寫入與資料遷移。
- 查詢不會漏掉遷移中的資料:記憶體與磁碟內容都仍須能依協定查詢,涉及同一區域的合併與讀取須適當同步。
- 安全發布新結果:發布新內容、更新導航與移除舊內容必須彼此協調,避免查詢看到不完整狀態;這不表示整個合併必須用一次 CAS 完成,舊頁也不能立刻任意回收。
參考 LSM-Tree 原論文:Two-component LSM-Tree 與 Rolling Merge。
Multicomponent LSM-Tree:用 Compaction 整理多份有序資料
MemTable 持續 Flush 後,磁碟上會累積多份有序 Tables/Runs;同一個 Key 的不同版本也可能分散其中。 Compaction 按政策合併選定的 Runs,整理版本與可安全清除的刪除標記,控制查詢需要檢查或合併的資料來源數量。這裡改善的是讀取放大,不一定是讓單棵樹的高度變矮;合併本身仍要付出讀取與重寫資料的成本。
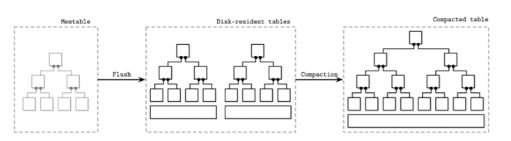
圖中示意 MemTable Flush 產生多份磁碟 Tables,再由 Compaction 合併。實際上不必每次把所有 Tables 合成一份,輸出也可能是多個檔案;Multicomponent 指記憶體之外還有多個磁碟元件/層級,一個層級可以包含多個 Tables,不能直接把每個檔案都當成一個層級。
Merge-Iteration:按序走訪,再判斷有效版本
查詢範圍時,資料可能分散在 MemTables 與多份 SSTables。每個來源本來就依 Key 排序,因此可以各自使用 Iterator(迭代器) 逐筆走訪;Cursor(游標) 則保存目前的位置,像書籤一樣。Iterator 提供定位、讀取目前紀錄與前進等操作,不必一次載入整份 Table。
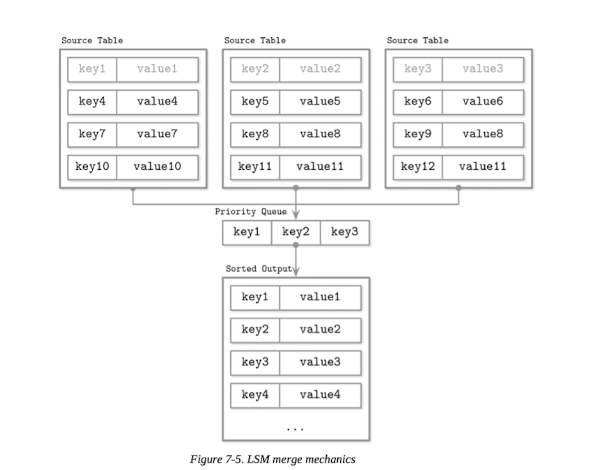
圖 7.5 的三個來源分別有 1、4、7、10、2、5、8、11、3、6、9、12。先將每個 Iterator 的 Head(目前候選紀錄)放進 Priority Queue;每次取最小 Key,再從它所屬的 Iterator 補下一筆。例如先比較 1、2、3,取出 1 後補入 4;接著比較 2、3、4,依此輸出有序結果。因為各來源已排序,只需比較各自的 Head,就能找出所有剩餘紀錄中最小的一筆。
Priority Queue 可以用 Min-Heap 實作,這裡不是一般的 FIFO Queue。若有 N 個來源,通常只需維護至多 N 個 Head;Heap 每次取出與補入的成本為 \(O(\log N)\),候選空間為 \(O(N)\)。
書中的例子:相同 Key 要再判斷版本
| Iterator 1 | Iterator 2 |
|---|---|
| k2 → v1 | k1 → v3 |
| k4 → v2 | k2 → v4 |
| k3 → v5 |
- 初始化:取兩邊的 Head,候選為
k2 → v1、k1 → v3。 - 取出 k1:k1 最小,輸出
k1 → v3;從 Iterator 2 補入k2 → v4。 - 整合 k2 的版本:候選同時有
k2 → v1與k2 → v4。書中保留 v4,這須由版本資訊及衝突處理規則決定,不能只因它來自 Iterator 2 就認定較新。 - 繼續前進:處理完兩筆 k2,兩邊各補入下一筆,得到 k4、k3,再依序輸出 k3、k4。
最後的有效結果是 k1 → v3、k2 → v4、k3 → v5、k4 → v2。若讀取模型允許同一來源保留同 Key 的多個版本,也須持續消化相關紀錄,不能假設一個 Head 就代表該來源的全部版本。
Merge-Iteration、Conflict Resolution 與 Reconciliation
| 概念 | 在這裡負責的工作 |
|---|---|
| Merge-Iteration(合併迭代) | 按 Key 順序取出不同來源的紀錄,讓相同 Key 的版本能一起處理。 |
| Conflict Resolution(衝突處理) | 依版本順序、可見性與 Tombstone 規則,決定哪些值可回傳。 |
| Reconciliation(整合) | 結合各來源與版本判斷,形成有效資料的整體過程。 |
這是概念分工,實際可以邊迭代、邊整合。例如更新的 Tombstone 遮蔽舊值時,查詢不能再回傳被刪除的版本。讀取合併可直接產生查詢結果,不必先完成 Compaction;Compaction 則把整理後的內容寫成新檔案,且舊版本是否可丟棄還要考慮快照等保留需求。
LSM-Tree 的維護:Compaction 與垃圾回收
LSM-Tree 持續寫入後,同一個 Key 的新舊版本與刪除標記可能散落在多份 SSTables。查詢透過版本整合取得有效結果,背景則透過 Compaction 重寫選定的檔案,順便回收不再需要的紀錄;這是 LSM-Tree 常見的垃圾回收方式,不是每次更新都立即刪除舊值。
Leveled Compaction(分層合併)
以下先採用「MemTable Flush 後,建立 SSTable 並歸入 L0」的基本模型。新寫入先在記憶體累積,Flush 才把它變成磁碟檔案;L0、L1、L2 都是磁碟 SSTables 的管理層級。接著在符合條件時,用 Compaction 逐層整理:MemTable → Flush → L0 → Compaction → L1 → Compaction → L2。
這是理解後面範例的前提,實際路線由引擎決定。例如 LevelDB 在沒有範圍重疊、且符合其他限制時,Flush 輸出可直接歸到 L1 或 L2,省掉中間整理;後面的例子先沿用逐層合併的基本模型。參考 LevelDB:PickLevelForMemTableOutput。
為什麼要合併?先看觸發時機
MemTable 持續 Flush,磁碟上的 SSTables 就會逐漸增加;如果放著不整理,同一個 Key 的版本可能散落在更多檔案,增加查詢成本。Leveled Compaction 把檔案分成容量通常逐層增加的 L0、L1、L2 等 Levels,並在某層達到設定門檻時,安排資料往下一層整理。
門檻決定「何時做」,檔案選擇與 Key 範圍重疊則決定「合併哪些」。以下是常見的基本模型,實際門檻與其他觸發條件依引擎而異:
| 層級 | 常見觸發條件 | 整理方向 |
|---|---|---|
| L0 | SSTable 檔案數達到設定門檻 | 選定 L0 檔案,與 L1 重疊檔案合併 |
| L1、L2 等 | 該層總資料量超過容量目標 | 選定該層檔案,與下一層重疊檔案合併 |
這裡假設 L0 累積到 4 份 SSTables 就觸發整理,L1 超過 100 MB 就安排往 L2 合併。
Level 不是固定的 Key 區間
L0、L1、L2 是檔案的管理層級,不是 B-Tree 的樹高,也不是「L0 固定存 1~20、L1 固定存 21~40」。每份 SSTable 才有自己的 Key 範圍,由檔案內最小與最大的 Key 決定;範圍中不必每個 Key 都存在。引擎透過 Metadata 記錄各檔案的層級與範圍,不必真的用不同資料夾代表每一層。
在常見的基本流程中,MemTable Flush 產生的 SSTable 先歸入 L0,因此 L0 可以有很多檔案,而且範圍可以重疊;L1 以後則維持同層檔案的 Key 範圍不重疊。跨層範圍仍可以重疊,同一個 Key 的版本也可能出現在不同層。
用 X、P、Q 看一次合併
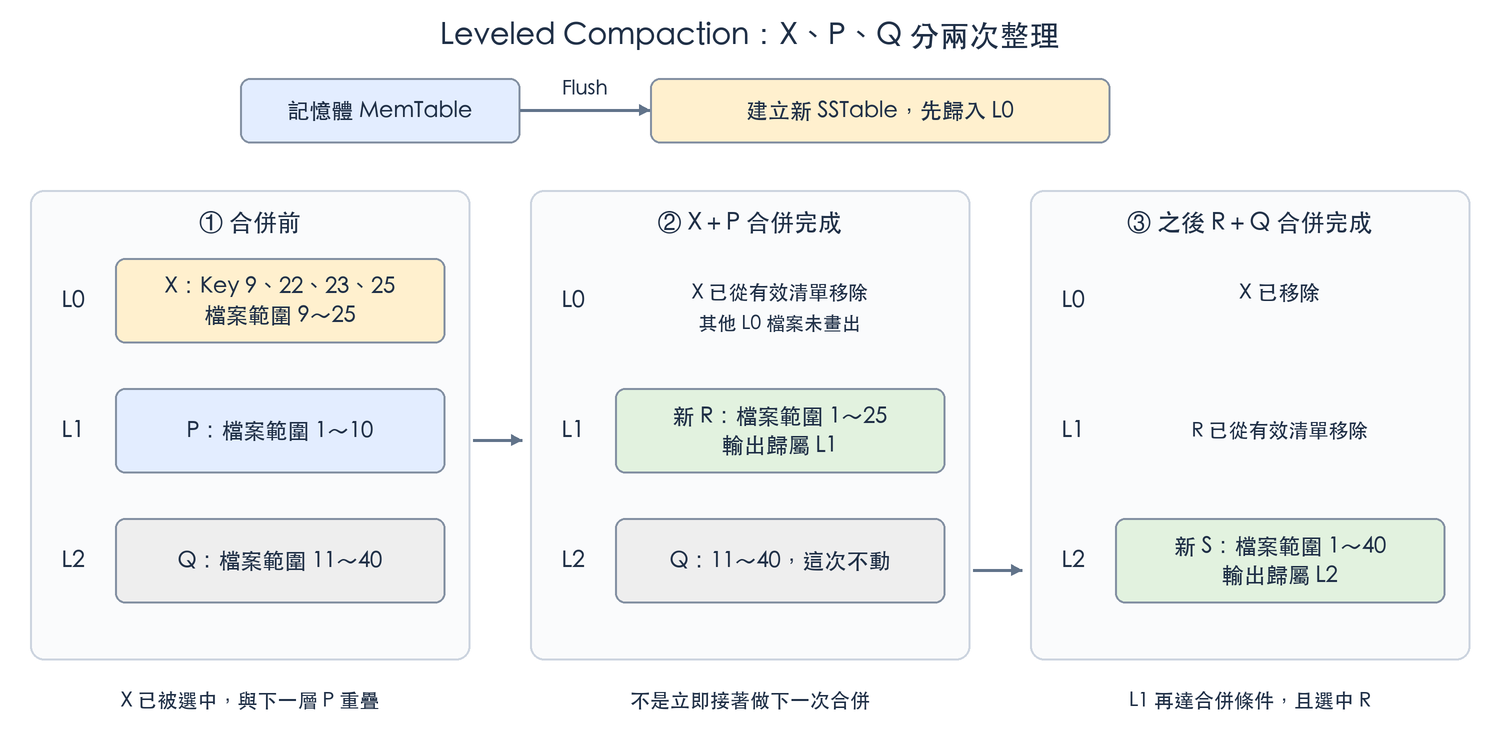
圖中先從 Flush 進入 L0 的前提開始,再依序顯示兩次獨立的 Compaction;第二次必須等 L1 的合併條件與檔案選擇成立,不是第一次完成就自動接著做。
假設目前檔案如下,且排程已選中 L0 的 X 進行 Compaction;這張表只列出相關檔案,不表示一份 X 就一定達到觸發門檻。
| 層級 | SSTable | 內容/Key 範圍 |
|---|---|---|
| L0 | X | Key 9、22、23、25,範圍為 9~25 |
| L1 | P | Key 範圍 1~10 |
| L2 | Q | Key 範圍 11~40 |
- 選擇輸入:X 的 9~25 與下一層 P 的 1~10 重疊,所以這次合併 X 與 P;Q 位於 L2,基本流程中這次先不處理。
- 寫出新 SSTable:按 Key 合併 X、P,判斷版本與刪除標記。簡化假設輸出一份新的 R,範圍為 1~25,歸屬 L1;實際輸出也可能拆成多個檔案。
- 安全替換舊檔案:R 完成並發布後,X、P 從有效檔案清單移除;舊檔案沒有讀者需要時再回收。其他未參與的 L0 檔案保留,若 L0 原本只有 X,才會暫時變空。
- 之後再處理 L1 → L2:等 L1 達到容量等合併條件,且 R 被選中時,才將 R 與範圍重疊的 Q 合併,輸出新的 L2 檔案;不是 X 合併完就一定立即一路做到 L2。
「往下一層」通常是讀取舊檔案、建立歸屬下一層的新 SSTables,而不是直接原地修改舊檔案。若下一層另有範圍 41~50 的 D,它與本次 X/R 的範圍不重疊,就不必參與上述合併。每次輸出的分界由保留資料與檔案大小等規則決定,不會永遠固定為原來的範圍。
Leveled Compaction 的取捨
RocksDB 預設採用 Leveled Compaction(kCompactionStyleLevel),也可設定為 Universal、FIFO 等其他策略。它依 L0 檔案數與其他層的容量目標等條件安排合併;啟用動態層級容量配置時,L0 的輸出也可能略過保持為空的層,直接合併到目前的 Base Level,因此不一定固定經過 L1。參考 RocksDB:Leveled Compaction。
L1 以後同層範圍不重疊,讓單一 Key 在每層只需考慮一份範圍候選檔案;代價是 Compaction 可能反覆重寫下一層的重疊資料,增加寫入放大。參考 Cassandra:Leveled Compaction。
Size-Tiered Compaction(依大小分組合併)
先把大小相近的 SSTables 分成一組,累積到設定門檻後再合併成較大的 SSTable;較大的檔案之後也能與相近大小的檔案再次合併。它主要依檔案大小選擇輸入,不保證同組或不同組的 Key 範圍不重疊,因此同一 Key 的版本可能分散在多個檔案,增加查詢與空間成本。參考 Cassandra:Size-Tiered Compaction。
同一個 Key 的更新與刪除
用一個簡化的 Key-Value 模型表示使用者資料:Key 是 user:42,Value 是姓名與 Email。下面的 v1、v2 只是內容版本的示意名稱;實際引擎另有序號、時間戳等版本資訊,不能只靠 Value 判斷新舊。
| 操作順序 | 寫入的紀錄 | 最新狀態的查詢結果 |
|---|---|---|
| 原本資料(v1) | user:42 → {name: Walle, email: [email protected]} |
舊 Email |
| 修改 Email(v2) | user:42 → {name: Walle, email: [email protected]} |
新 Email |
| 刪除使用者 | user:42 → Tombstone |
不存在 |
| 重新建立使用者(v3) | user:42 → {name: Walle, email: [email protected]} |
重新建立的資料 |
Delete 是刪除這個 Key 的邏輯資料,不是只擦掉最新版本、讓舊版本重新出現。因此刪除要留下 Tombstone,遮蔽它之前的值;之後若有更新的 Put,這個 Key 可以重新存在。最新查詢看到 v3,不代表 v1、v2 與 Tombstone 已立即從磁碟移除。
什麼時候能清掉舊版本與 Tombstone?
Compaction 處理到相關紀錄時,要確認舊版本已不再被需要。例如支援 Snapshot 的引擎中,刪除前的快照可能仍須讀到 v2,刪除後、重新建立前的快照則須看到「不存在」。Tombstone 若仍需遮蔽未納入這次合併的舊資料,也不能隨便移除,否則可能讓舊值復活。
當沒有快照或其他保留需求,而且能確認不會露出舊值時,Compaction 可以略過舊版本與不再需要的 Tombstone;不必每次都清掉全部歷史。以這個例子而言,安全整理後最終可以只留下 v3。相關判斷可見 LevelDB 的 Compaction 實作。
Cassandra 另須考慮其他副本是否錯過刪除,因此以 gc_grace_seconds 保留 Tombstone 一段時間。超過期限只是可能符合回收資格,仍須在 Compaction 中滿足安全清理條件;保留期限本身不保證副本已同步,還要配合適當的 Repair,避免舊資料復活。參考 Cassandra:Tombstones。
清理時會重建整棵樹嗎?
常見 SSTable 實作會合併選定檔案,把仍須保留的紀錄寫成新的 SSTables,並建立新檔案的索引,再安全發布檔案清單。舊檔案等到沒有讀者需要時才回收;它不是直接從不可變的舊檔案中擦掉某筆資料,也通常不需要重建整棵 LSM-Tree。前面的 Two-component 磁碟樹模型,則可理解成重建受影響的子樹,再接回磁碟樹。
Read、Write、Space Amplification 與 Bloom Filter
Compaction 策略與版本回收決定了資料如何維護,接著從讀取、寫入與空間三個面向看它們帶來的成本,以及各種最佳化的作用。
Read Amplification(讀取放大)
取得一筆有效資料,可能需要查詢多個 SSTables、讀取索引與資料區塊,並整合版本。這些額外讀取形成 Read Amplification;相關最佳化要減少不必要的檔案與區塊存取。
Bloom Filter:先排除不含目標 Key 的檔案
Bloom Filter 判斷某個 Key「一定不存在」或「可能存在」,讓查詢略過確定不含該 Key 的 SSTable。以下用 每份 SSTable 配一份 Filter Array 的模型說明;它是檔案的附帶資訊,實際可以放在檔案內的 Filter 區段或附檔,讀取時再載入或快取到記憶體。
建立:同一份 SSTable 的所有 Key 共用一份陣列。假設 SSTable A 只有 key1、key2,準備 16 個初始為 0 的 Bits,以及三個固定的 Hash Functions。每個 Key 都使用相同的三個 Hash,得到三個位置,並把那些位置設成 1;不是一個 Key 配一個 Hash,也不是每個 Key 建一份 Filter。
| SSTable A 裡的 Key | 三個 Hash 算出的位置 | 對同一份 Filter 的操作 |
|---|---|---|
| key1 | 3、5、10 | 把位置 3、5、10 設成 1 |
| key2 | 5、8、14 | 把位置 5、8、14 設成 1,既有的 1 保留 |
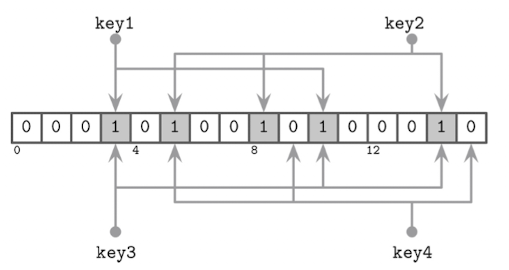
圖中上方的 key1、key2 用於建立 Filter,下方的 key3、key4 只用於查詢,沒有加入 SSTable。
最後位置 3、5、8、10、14 為 1,其餘為 0。保存的是累積記號的 Bit Array,不必替每個 Key 另外保存它算出的三個位置。因為同一 Key 使用同一組 Hash 一定會得到相同位置,查詢時可以重新計算。
查詢:只計算目標 Key,再核對這份 Filter。沿用圖中的 Hash 結果:
| 查詢的 Key(皆未加入) | Hash 位置 | 對應 Bits | 判斷與後續動作 |
|---|---|---|---|
| key3 | 3、10、14 | 1、1、1 | 可能存在,須查 SSTable;實際沒有,是 False Positive |
| key4 | 5、9、15 | 1、0、0 | 一定不存在,直接跳過 SSTable |
key3 的三個位置恰好都被 key1、key2 設為 1,Filter 無法知道記號是哪個 Key 留下的,因此產生誤判;key4 則因位置 9、15 是 0,可以直接排除。正常建立且與資料正確對應的 Filter,不會把實際加入過的 Key 判成不存在。多份 SSTables 各自檢查對應的 Filter,不必每次重新掃描所有來源 Keys。
下面用 C 虛擬碼把建立與查詢接起來。bool 陣列只為方便理解,實作可以把多個 Bits 打包儲存;Hash 內容省略,假設三個固定的 Hash Functions 適合此示例。
#define BIT_COUNT 16

typedef struct {
    bool bits[BIT_COUNT];
} BloomFilter;

// 同一個 Key 每次都算出相同結果;這三個 Hash 供所有 Keys 共用。
unsigned hash1(const char *key);
unsigned hash2(const char *key);
unsigned hash3(const char *key);

void bloom_add(BloomFilter *filter, const char *key)
{
    unsigned p1 = hash1(key) % BIT_COUNT;
    unsigned p2 = hash2(key) % BIT_COUNT;
    unsigned p3 = hash3(key) % BIT_COUNT;

    filter->bits[p1] = true;
    filter->bits[p2] = true;
    filter->bits[p3] = true;
}

bool bloom_might_contain(const BloomFilter *filter, const char *key)
{
    unsigned p1 = hash1(key) % BIT_COUNT;
    unsigned p2 = hash2(key) % BIT_COUNT;
    unsigned p3 = hash3(key) % BIT_COUNT;

    if (!filter->bits[p1] || !filter->bits[p2] || !filter->bits[p3]) {
        return false;  // 任一格為 0:一定不存在
    }
    return true;       // 全部為 1:可能存在,仍須查 SSTable
}

// 建立 SSTable A 的 Filter。
BloomFilter filter_a = {0};
bloom_add(&filter_a, "key1");
bloom_add(&filter_a, "key2");
// 將 filter_a 保存為 SSTable A 的附帶資訊。

// 查詢時使用已保存/載入的 Filter;假設 Hash 結果如上表。
// key3 沒有加入,但三格都是 1,所以會進入進一步查找。
if (bloom_might_contain(&filter_a, "key3")) {
    search_sstable("A", "key3");  // 實際找不到:False Positive
}

// key4 的三格是 1、0、0,因此直接跳過。
if (bloom_might_contain(&filter_a, "key4")) {
    search_sstable("A", "key4");  // 可能存在,進一步查找
} else {
    // 一定不存在,跳過 SSTable A。
}
% BIT_COUNT 把結果限制在陣列編號 0~15。Filter 不保存 Value,也不負責判斷版本是否已刪除;即使回答可能存在,後續仍須處理版本與 Tombstone。這裡的 16 Bits、3 個 Hash 只是示例,實際大小與 Hash 數量須配合預期 Key 數與誤判率選擇。
Secondary Index:透過非主鍵欄位定位資料
Bloom Filter 用來排除不含目標 Key 的檔案;Secondary Index 則提供另一條查找路徑。例如已知 email = [email protected],可以先透過 Email 索引取得 user:42,再定位並讀取使用者資料,避免為了非主鍵條件掃描大量紀錄。B-Tree 的次級索引也有相同用途,基本概念見 Database Internals。
書中以 Cassandra 的 SSTable-Attached Secondary Indexes(SASI) 為例:記憶體中的更新有對應索引,磁碟上則為各 SSTable 建立次級索引,索引生命週期隨 Flush/Compaction 管理。查詢相關索引取得候選 Primary Keys 後,仍須整合資料版本與刪除標記。這是特定的索引設計,不代表所有 SSTable 都自動附帶 Secondary Index。
Secondary Index 能降低這類欄位查詢的掃描成本,但建立與維護索引也會增加寫入及空間成本;它不是直接降低 Write Amplification 的方法。
Write Amplification(寫入放大)
應用程式的一筆更新,可能在 WAL、Flush 與後續 Compaction 中產生多次寫入。Compaction 策略會影響資料被重寫的次數與範圍;比較放大程度時,要先統一是否計入 WAL 等衡量範圍。Compaction 在這裡指資料整理與重寫,和 Compression 是不同機制。
Open-Channel SSD:協調資料放置與回收
Open-Channel SSD 將部分原本由 SSD 內部 FTL(Flash Translation Layer)負責的管理工作,開放給主機端軟體控制。主機就是使用 SSD 的電腦或伺服器;主機端軟體則是由其 CPU 執行的驅動程式或儲存管理軟體。
一般 SSD 主要由內部控制器決定資料的實體位置,並處理位址對映、垃圾回收與磨耗管理。Open-Channel SSD 提供更多底層布局資訊與操作能力,讓主機端軟體依資料的存取模式與生命週期,協調資料放置、回收及 I/O 排程。例如將可能一起失效的資料集中存放,回收時就可能減少搬移仍有效資料的成本,降低 SSD 層的寫入放大。Open-Channel SSD 官方文件
LOCS 是結合 LSM-tree 與 Open-Channel SSD 的 Key-Value 儲存系統,透過暴露 Flash Channels 等底層資訊,協調 LevelDB 的資料布局與 I/O 排程。SDF(Software-Defined Flash)則是軟硬體共同設計的例子,讓寫入單位配合 Flash 的抹除區塊,藉此改善寫入與回收效率。LOCS 論文介紹、SDF 原論文
這些工作由主機端儲存軟體與裝置協作完成。MMU 負責 CPU 存取記憶體時的虛擬位址轉換與權限檢查;Open-Channel SSD 移交的則是 Flash 儲存管理責任,兩者屬於不同層次。
O_DIRECT 也讓應用程式承擔更多管理責任以取得控制權,但它主要繞過 OS Page Cache,不會繞過一般 SSD 的 FTL。快取與直接 I/O 的說明見 Database Internals。
這種設計需要相容的裝置與軟體配合,也會增加主機端的實作複雜度。它能改善跨層的資料放置與回收安排,但仍須支付垃圾回收與 LSM Compaction 的寫入成本。
延伸:Key–Value Separation
當 Value 遠大於 Key,WiscKey 透過把 Value 分離到 Value Log,讓 Key LSM 的 Compaction 主要搬移 Key 與位置資訊,減少大型 Value 反覆重寫的成本;Value 的過時資料則另行回收。它與 Bitcask 的設計差異,見 Unordered Log-Structured Storage:Bitcask 與 WiscKey。
Space Amplification(空間放大)
同一 Key 的舊版本、Tombstones、索引與 Filter,以及 Compaction 期間新舊檔案並存,都可能占用額外空間。Compaction 與垃圾回收清除不再需要的紀錄;Compression 則縮小保留資料的位元組大小,兩者可以一起降低磁碟占用,但壓縮本身不會消除舊版本。
Compression:透過 Offset Table 定位頁面
Compaction 是合併整理檔案,Compression 則是把資料編碼成較少的位元組。兩者可以搭配:Flush 或 Compaction 產生新的不可變 SSTable 時,可以依序壓縮並寫出資料區塊,以減少儲存空間與讀取的資料量;讀取時則要付出解壓縮的 CPU 成本。
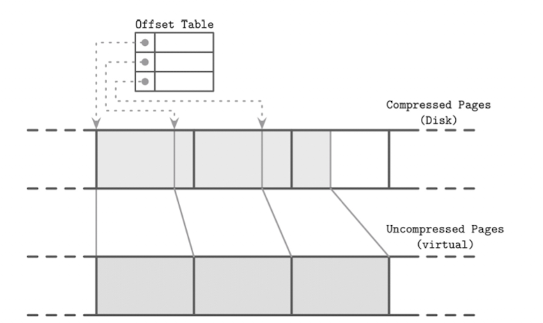
圖中下方是未壓縮的邏輯 Pages,上方是磁碟上長度不一的壓縮 Pages。原本固定大小的頁面壓縮後,不再按原 Page Size 對齊,所以不能只用「頁號 × 原頁大小」定位磁碟內容。引擎需要額外的 Offset Table/索引,記錄各壓縮區塊的起始 Offset 與長度;對應資訊可放在檔案中的獨立區段。
例如假設每個未壓縮頁面為 4 KiB,忽略檔案 Header 等額外開銷,壓縮後可有以下配置:
| 邏輯頁面 | 未壓縮 Offset | 壓縮後的磁碟 Offset | 壓縮長度 |
|---|---|---|---|
| P0 | 0 | 0 | 1536 Bytes |
| P1 | 4096 | 1536 | 1024 Bytes |
| P2 | 8192 | 2560 | 2048 Bytes |
讀取 P1 時,先查映射,從磁碟 Offset 1536 讀取 1024 Bytes,再解壓縮成原本的 4 KiB 頁面。圖中的「Uncompressed Pages(virtual)」表示未壓縮的邏輯配置,不必在磁碟上另存一整份未壓縮副本。若把壓縮後的每頁再補零到原本大小,就會失去相應的空間節省;對無法有效縮小的區塊,實作也可以保留未壓縮內容,具體格式依引擎而定。