Hashing
My vault 資料結構筆記:Hashing。
名詞解釋和定義
-
模型 表分成 $b$ 個 bucket,每個 bucket 有 s 個 slots;第 $i$ 個 bucket 目前放入筆數 $n_i$。
$$ T=b\cdot s $$
-
定義
-
Collision(碰撞):也就是 $\text{hash}(x)=\text{hash}(y)$存在某個 bucket 內至少兩筆。 $\exists i: n_i\ge 2$
-
Overflow(溢位):也就是資料剛好映射到這個 bucket,但是剛好這個 bucket 裡面的 slots 都滿了就是 Overflow。 $\exists i: n_i> s$
- 一些探討:也就是說 Overflow 他一定就會有 Collision,反之不一定,也就是說 Collision 他不一定會有 Overflow,但是今天如果 slot 大小他只有 1 的話那麼 Collision 他就會有 Overflow
-
-
識別字密度(Identifier Density):表示在整個變數(鍵值)空間中,實際被使用的變數比例。==若程式中有 $n$ 個實際使用的鍵,整體可用鍵空間大小為 $T$,則 $n/T$稱為識別字密度。此值越小,代表空間越稀疏、浪費越多。==(MIT 課程中對應於 $n/u$,說明若 $u$ 遠大於 $n$,直接存取表會造成 $O(u)$ 空間浪費。)
-
識別字密度(Identifier Density)範例
-
情境:全校學號為 9 位數(000000000–999999999),可用識別字總數 $T=10^9$;本學年實際註冊學生 $n=300$。
-
計算:
$$
\text{Identifier Density} = \frac{n}{T} = \frac{300}{109} = 3\times10{-7}
$$ -
解讀:學號宇宙極大但實際用到的位數使用很少;若用直接存取結構需配置 $10^9$ 格,空間浪費嚴重。
-
-
-
負載密度(Loading Density)或負載因子(Loading Factor):當雜湊表劃分為 $b$ 個 bucket、每個 bucket 含 $s$ 個 slot 時,==$n/ (b\times s)$即為負載密度。此值代表表格的實際填滿程度。值越大,表示空間使用率高,但發生**碰撞(Collision)或溢位(Overflow)**的機率也會上升==。(MIT 課程中對應於 $n/m$,並指出當 $m\propto n$ 時能維持常數期望搜尋時間 $O(1)$。)
-
負載密度(Loading Density / 負載因子)範例
-
情境:以「學號最後一碼」作為雜湊 $hash(id)=id \mod 10$,因此 bucket 數 $b=10$;每個 bucket 預留 $s=50$ 個 slot。總槽數 $m=b*s=500$;同樣 $n=300$ 位學生要放入表中。
-
計算:
$$
\alpha = \frac{n}{b\cdot s} = \frac{300}{10\cdot 50} = \frac{300}{500} = 0.6
$$ -
解讀:表格整體填滿 60%;平均每個 bucket 約 30 筆,未達 overflow(每 bucket 上限 50)。若 n 增加而 b、s 不變,則 $\alpha$ 變大,碰撞次數變多,最終可能出現 overflow。
-
-
Hashing 優點
-
使用 Hashing 進行搜尋,資料不需事先排序。
-
在無 Collision 與 Overflow 的情況下,查找一次讀取即可;期望時間 $O(1)$ 最壞情況(碰撞嚴重、鏈過長或開放定址接近滿表)為 $O(n)$,Overflow 後如下圖可以接在該 bucket 底下那麼這樣會 $O(n)$。
Idx: 0 1 2 3 4 [ ][ ] [ ][ ] [ ][ ] [13][23] -> [33] -> [43] -> null [ ][ ] … # 查找 43 的路徑:bucket 3 的 2 槽掃完 → 走溢位鏈直到 43 或 null # 最壞:所有 n 筆都在同一 bucket,鏈長 ≈ n - s -
具遮掩效果:未知雜湊函數時不易直接定位到資料(僅為遮掩,非密碼安全)。
-
可縮小索引範圍:以雜湊函數將大型識別空間映射到較小的表中,降低儲存與索引成本(概念近似「壓縮」,但非一般可逆壓縮)。
Hashing function design
平方值取中間位數(Middle square)
-
步驟:鍵先平方,擷取平方值的中間數位作位址。
-
範例:鍵 8125,表大小 1000(位址 0–999)。
$$8125^2 = 66015625 \
\text{取中間三位} = 156 $$ -
評述:實作簡單;分佈品質差,易碰撞與短循環,實務少用。
除法(Mod 運算)
-
定義:
$$h(x)=x\bmod M$$ -
選 (M) 原則:
-
取質數,且與鍵的進位基底(如 10)無明顯關聯。
-
避免 $M\mid (R^k\pm a)$ 型式 $R$ 為基底,$(k,a)$ 小整數。
-
避免 $M$ 為 2 的冪或與鍵模式有公因數。
-
表大小常取 $M\approx n$ 的鄰近質數。
-
-
評述:分佈穩定,實務最常用。
折疊相加(Folding Addition)
- 把鍵切成等長區段(最後一段不足就左補 0),各段相加後再取表大小 $m$ 的餘數作位址。$$h(x)=S \bmod m$$
- 分段為 $(P1=123,P2=203,P3=241,P4=112,P5=20)$。
-
位移折疊(Shift addition):各段照原順序直接相加。$$123+203+241+112+020= 699$$
-
邊界折疊(Boundary addition):每隔一段把數字「倒序」後再加(P2、P4… 反轉,也就是偶數把它整個反過來)。$$123+302+241+211+020= 897$$
-
位移折疊得 $S=699$,邊界折疊得 $S=897$。若表大小 $m=1000$,位址分別為$$699 \quad\text{與}\quad 897$$
-
邊界折疊比位移折疊更能打散高相似度鍵,碰撞通常較少。
-
數值分析:可能有 10 位數那麼就是把每個位數去看,例如第 10 位他的 2 重複很多那就把 2 刪掉又或是像是電話 09 開頭那麼我就把 09 刪掉用其他當作辨識。
Universal hash function
什麼是雜湊族 (Hash Family)?
雜湊族(或稱萬用雜湊族 $H$)是一個雜湊函數的集合。
- 目的: 如果我們使用一個固定的雜湊函數,攻擊者或特定的輸入資料可能總是會造成最差情況的碰撞。為了避免這種情況,我們不會預先選定一個固定的函數。
- 方法: 我們會隨機地從這個雜湊族 $H$ 中選取一個雜湊函數 $h_{a,b}$ 來使用。由於使用者不知道我們選了哪一個函數,這使得他們很難提供會導致大量碰撞的「壞」輸入。
- 結果: 萬用雜湊族保證了:即使對於任意兩個不同的鍵值,它們發生碰撞的機率也會很低(小於等於 $1/m$)。
萬用雜湊公式 $h_{a,b}(K)$ 中的變數
公式 $h_{a,b}(K) = ((aK + b) \pmod p) \pmod m$ 是一種常見的萬用雜湊函數設計。
以下是公式中各個參數的解釋:
| 變數 | 意義 | 來源/定義 | 功用 |
|---|---|---|---|
| $K$ | 鍵值 (Key) | 是要進行雜湊的原始輸入 (例如,一個整數)。 | 原始資料。 |
| $m$ | 雜湊表大小 (Table Size) | 雜湊表 (hash table) 的長度,結果會映射到 $[0, m-1]$ 範圍內。 | 確定最終的儲存位置。 |
| $p$ | 大質數 (Large Prime) | 一個在建表時固定的質數,必須大於所有可能鍵值的最大值 $u$。 | 用來在第一次模運算前充分「打亂」鍵值,增加隨機性。 |
| $a, b$ | 隨機參數 (Random Parameters) | 這是在建立雜湊表時,隨機選取的兩個參數。它們決定了您使用的是雜湊族中的哪一個特定函數。 | $a$ 在 $[1, p-1]$ 範圍內隨機選取($a$ 必須不為零)。$b$ 在 $[0, p-1]$ 範圍內隨機選取。 |
這個公式分兩階段運算:
- 先做 $(aK + b) \pmod p$,在一個大質數 $p$ 的範圍內打亂鍵值。
- 再做 $\pmod m$,將結果壓縮到雜湊表大小 $m$ 的範圍內。
Proof
在採用 universal hash(對任兩鍵碰撞機率 $\le 1/m$)且表大小 $m=\Omega(n)$(負載因子 $\alpha=n/m=O(1)$)時,任意鍵 $k_i$ 於索引 $h(k_i)$ 的期望鏈長滿足 $\mathbb{E}[X_i]\le 1+(n-1)/m=1+\alpha-1/m=O(1)$,因此成功查找的期望比較次數 $S_n=1+\alpha/2$,失敗查找 $U_n=\alpha$。
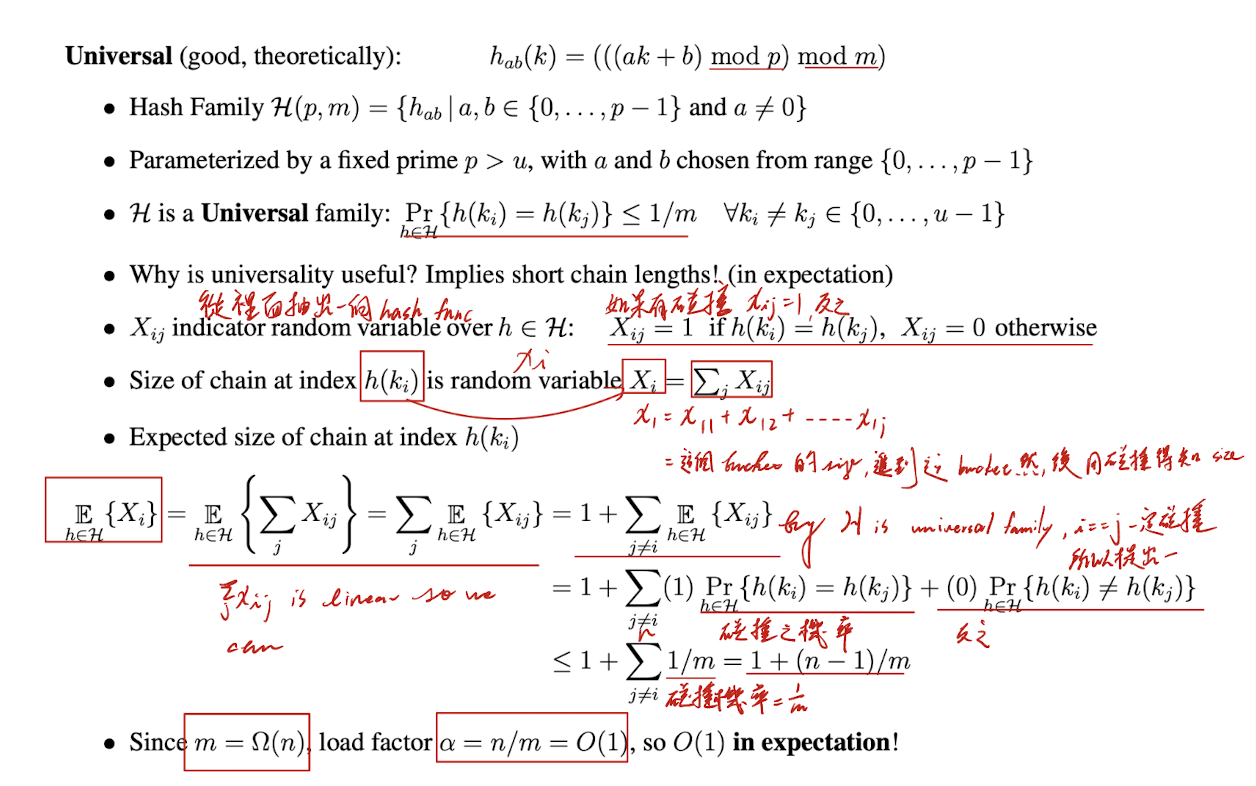
-
失敗查找:$U_n=\alpha$
-
成功查找:$S_n=1+\frac{\alpha}{2}$
-
$\alpha=\frac{n}{m}$=每個 bucket 平均有幾筆。
-
失敗時要把該 bucket 的鏈看完整條,所以平均比 $\alpha$ 次。
-
成功時你比較常掉進「較長的鏈」(不是平均的那條)。那條鏈平均長度≈$1+\alpha$;目標大概在鏈的中間,所以先看一半的其他元素 $\alpha/2$,再加上命中那一次 ⇒ $1+\alpha/2$。
- 小例:$m=100,\ n=200\Rightarrow \alpha=2$ 失敗平均比 $2$ 次;成功平均比 $2$ 次。
Overflow 處理方式
Open addressing mode
Linear Probing(線性探測)
-
意義:碰撞時沿著表向右一格一格找空位。
-
探測序列:
$$\text{probe}_i=(h(x)+i)\bmod B, i=0,1,\ldots,B-1$$ -
終止:遇到空格即放入;或繞行一圈皆滿。
-
優點:實作簡單、快取友善。
-
缺點:Primary clustering,連續已占區段會持續變長,平均探測步數上升。
-
例(B=10,h(k)=k mod 10;插入 13,23,33):
Idx: 0  1  2   3   4  5   6  7  8  9
	[ ][ ][ ][13][23][33][ ][ ][ ][ ]
# 33: 3(占)→4(占)→5(空) 放入
Quadratic Probing(二次方探測)
-
意義:碰撞時用平方距離跳探,避開一大段連續區。
-
常見序列:
$$\text{probe}_i=(h(x)+i2)\bmod B\quad\text{或}\quad (h(x)\pm i2)\bmod B$$ -
i 的範圍常取到 $\lfloor B/2\rfloor$,因平方模數對稱,之後會重複。
-
優點:解 Primary clustering(因為不連著走)。
-
缺點:Secondary clustering(同一個初始雜湊值的鍵,其探測序列完全相同而彼此聚集);且不保證探遍全表,可能尚有空格卻插入失敗。
-
例$B=11,h(x)=3$: $$i^2\bmod 11: 0,1,4,9,5,3,3,5,9,4,1$$ $$\Rightarrow\text{probe}: 3,4,7,1,8,6,6,8,1,7,4 \text{(後續重複)}$$
僅前 6 個位置不同 → 不一定用滿整張表。 -
對照
-
Linear:序列連續 → 容易 Primary clustering。
-
Quadratic:序列非連續 → 解 Primary,但同 hash 值的鍵仍走相同序列 → Secondary clustering;且可能無法利用到所有空格。
-
兩者最壞查找皆可能達 $\Theta(n)$;需控制負載因子 $\alpha=n/B$ 並定期擴表重雜湊。
-
Double Hashing
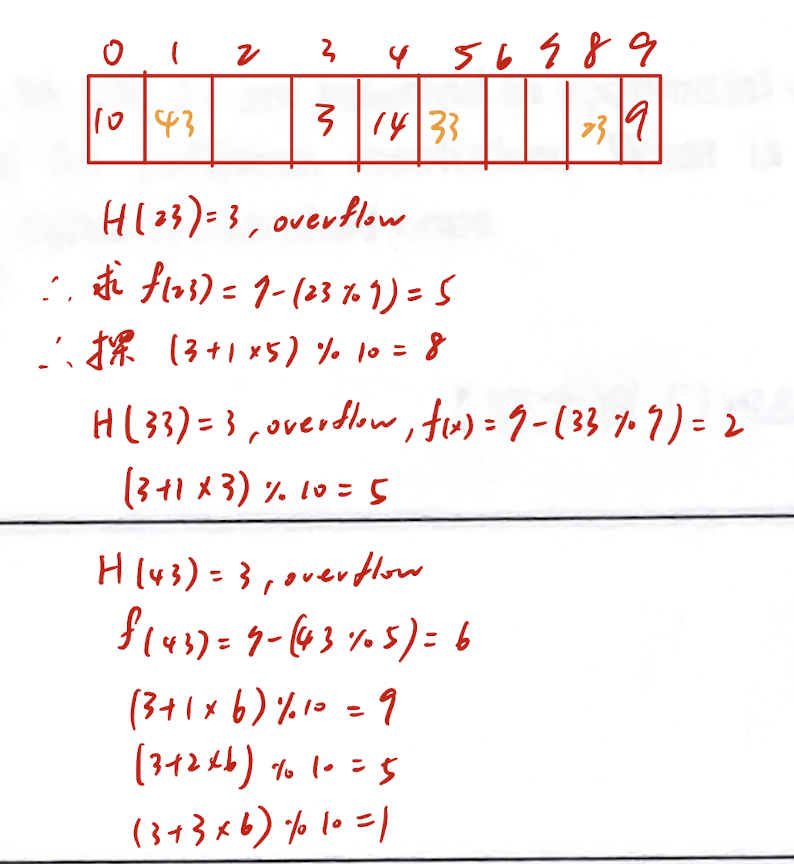
- 概念:碰撞時以第二雜湊決定步長,探測序列為 $\text{probe}_i= (H(x)+i\cdot f(x))\bmod B\quad(i=0,1,\ldots)$常用 $f(x)=R-(x\bmod R)$,$f(x)$ 這個會考試可能會換所以依照考試給定,其中 $R$ 為小於 $B$ 的質數且 $f(x)\neq 0$。
- 優點:避免 Primary clustering,並解 Secondary clustering。表空間不一定能完全利用。
- 範例 設 $B=10$,$H(x)=x\bmod 10$,選 $R=7$,故 $f(x)=7-(x\bmod 7)$。依序插入:$3,14,9,10,23,33,43$。
Close addressing mode
Chaining
-
定義:雜湊表視為有 (b) 個 buckets;雜湊位址相同的鍵放入同一個 bucket 的串列(或其他容器),形成「鏈結」。屬於 Closed addressing;對照 Open addressing 的探測法。
-
核心參數: $\alpha = \frac{n}{b}$,代表平均每個 bucket 的元素數。當 $\alpha$ 為常數時,期望查找時間為 $O(1)$。
-
時間複雜度:
-
插入:定位 bucket 後插入節點,平均 $O(1)$。
-
查找/刪除:平均 $O(1+\alpha)$,最壞 $O(n)$(所有鍵落同一 bucket)。
-
-
優點:
-
碰撞處理簡單,刪除容易。
-
不需維持 $\alpha<1$;表大小可小於 $n$。
-
同位址的鍵不影響其他 buckets(無 open addressing 的 primary/secondary clustering)。
-
-
缺點:
-
額外指標記憶體;快取友善度較差。
-
雜湊不均或 $\alpha$ 偏大時,串列變長,效能下降。
-
-
實作變體:bucket 內可用 linked list(預設)、動態陣列、或平衡 BST(使單 bucket 操作 $O(\log\text{bucket})$)。
-
小例:
 Bucket 0:  -> null
 Bucket 1:  -> [11] -> [21] -> [31] -> null
 Bucket 2:  -> null
 ...
Rehashing
-
設置一系列的散置函數 f1、f2、…、fn。當使用 f1 產生溢位時,則改用 f2,若又發生溢位時,則改用 f3,依此類推,直到沒有溢位發生為止。如果函數全部使用完,仍有碰撞,則資料無法存入。
-
此法也不保證表格空間一定可以被充分利用。