DDIA:Designing Data-Intensive Applications 閱讀筆記
DDIA:Designing Data-Intensive Applications 閱讀筆記的重點整理。
持續更新中的閱讀筆記 本筆記隨 DDIA 閱讀進度持續補充,先刊登目前已整理的內容,後續會更新至閱讀完成或一個完整段落。
Latency、Percentiles 與 SLI / SLO / SLA:Arithmetic mean 一般來說在衡量 latency 時會比較不夠有代表性,因為 latency 的 distribution 常常會有 outliers 和 tail latency。相較之下,使用 median 和 percentiles 會比較容易看出整個 latency distribution。例如 p50 = 200 ms,代表 50% 的 requests 都在小於或等於 200 ms 的時間內被回覆,而 p50 本身其實就是 median。實務上通常也會看比較高的 percentile,例如 p95、p99、p99.9,因為這些高 percentile 更容易看出 tail latency,也就是少數特別慢的 requests。Arithmetic mean 不是沒有用,而是如果只看 arithmetic mean,很容易把 latency distribution 裡面的極端慢 request 隱藏掉。
高 percentile 在實務上特別重要,因為它能觀察最慢的那一小部分 requests。在需要同時呼叫多個 backend service 的系統中,只要其中一個 backend response 特別慢,最終使用者的 request 通常也必須等待這個最慢的 backend 完成。因此 backend 呼叫數量越多,碰到慢 request 的機率也會增加,使整體 request 的 tail latency 被進一步放大,這種現象稱為 tail latency amplification。
這種 percentile 的表示方式也很常出現在服務可靠性管理中。常見的三個概念是 SLI、SLO 和 SLA。SLI(Service Level Indicator)是實際量測服務表現的指標,例如 latency、availability、error rate;SLO(Service Level Objective)是針對這些指標設定的目標,例如要求 99.9% 的 requests 必須在 1 秒內完成;SLA(Service Level Agreement)則是服務提供者與客戶之間正式約定的服務水準,若未達成可能涉及補償或 service credit。
Percentiles 很適合用在 SLO 和 SLA,因為它不是只描述平均 response time,而是可以直接規定多少比例的 requests 必須在某個 latency threshold 內完成。例如 p50 ≤ 200 ms,代表至少 50% 的 requests 在 200 ms 內完成,而 p99.9 < 1 s 則代表 99.9% 的 requests 必須在 1 秒內完成。這樣除了可以描述一般使用者的 response time,也能直接限制 tail latency,避免只有少數 requests 極度緩慢,但整體 arithmetic mean 看起來仍然正常的情況。
Maintainability:Maintainability 主要是在說:系統不只要能跑,還要讓未來的人容易維護、理解與修改。DDIA 將它拆成三個面向:
- Operability:讓 operations team 容易維持系統穩定運作,例如容易監控、除錯、部署、復原與處理故障。
- Simplicity:降低不必要的 system complexity,讓新的 engineers 容易理解整個系統。這裡的 simplicity 指的是系統內部設計簡單,不是 UI 簡單。
- Evolvability:讓系統未來容易修改與擴充,能隨 requirements 改變而調整,也常稱為 extensibility、modifiability 或 plasticity。
Maintainability 的核心就是:讓系統容易操作、容易理解、也容易修改。好的系統設計不只考慮現在能不能運作,也要考慮未來維護與需求變更的成本。
Scalability 與 Shared-Nothing Architecture:現代的大型 distributed systems 很常採用 shared-nothing architecture,每個 node 擁有自己的 CPU、memory 和 storage,並透過 network 互相協作。這類架構通常適合使用 scale-out,也就是增加更多 nodes 來提升系統容量,而不是單純依賴 scale-up 去購買更強大的單機。Scale-up 的架構通常比較簡單,但高階硬體成本會快速增加,而且最終會碰到單機硬體上限;scale-out 則具有較好的 elasticity,可以逐步增加 commodity machines,但同時也會引入 partitioning、replication、consistency、network failure 與 coordination 等 distributed system complexity。
不過,並不存在任何一種「magic scaling sauce」。沒有某種 architecture 或 technology 能夠不考慮 workload 就自動解決 scalability。良好的 system architecture 應該圍繞明確的 assumptions 建立,例如預期的 request rate、read/write ratio、dataset size、traffic pattern、latency requirements、availability requirements 以及 consistency requirements。只有先知道系統要面對什麼 workload,才能決定應該使用 scale-up、scale-out、partitioning、replication、caching 或其他設計。
Polyglot Persistence:Polyglot persistence 是在同一個系統中,依不同資料與 workload 的需求,混合使用不同的資料儲存技術,例如 NoSQL 和 RDBMS,而不是所有資料都只使用同一種 database。
以銀行系統作為假設案例:某些交易相關資料可以先寫入 NoSQL,再每天透過 batch 將需要的資訊寫入 RDBMS,供報表、彙整或其他查詢使用。這是 polyglot persistence 的一種搭配方式,不代表銀行交易系統一定採用這個流程。
選擇儲存方式時,仍須依交易資料的一致性、原子性與耐久性需求判斷,不能只用 NoSQL/RDBMS 的分類來決定。每天 batch 同步也表示 RDBMS 中的資料可能尚未反映最新交易;若用於即時餘額或交易判斷,就必須另外處理這個時間差。跨資料庫同步還需要考慮重複寫入、漏資料與失敗重試。
Read Repair 與 Anti-Entropy(資料修復機制):兩者都是為了解決 Replica 之間的資料不一致。Read Repair 在讀取時偵測並修復過期資料,適合經常被讀取的資料,但可能增加讀取延遲;Anti-Entropy 則透過背景程序定期比對與同步,適合大規模資料檢查或長期未被讀取的資料,例如金融對帳系統就可以借鑑 Anti-Entropy 的定期比對機制,但仍須額外處理交易差異與帳務正確性。兩者可以互補,協助採用最終一致性(Eventual Consistency)的分散式系統逐步達成資料收斂。
Leader-based Replication
| 複製架構 | 寫入方式 | 主要需要處理的問題 |
|---|---|---|
| Single-leader Replication | 同一份資料由一個 Leader 接受寫入,再複製到 Followers | Replication Lag、Leader 故障與 Failover;應用程式並行交易仍須處理 Lost Updates |
| Multi-leader Replication | 多個 Leader 可接受同一份資料的寫入,再互相複製 | 跨 Leader 的 Concurrent Writes、衝突偵測與合併 |
| Leaderless Replication | 多個 Replica 接受寫入,依讀寫協定協調 | Quorum、版本衝突、Read Repair 與 Anti-Entropy |
Single-leader Replication(單一主節點複製):對同一份資料,所有寫入先送到同一個 Leader/Primary,由它安排更新順序,再將變更傳給 Followers/Standbys。PostgreSQL 原生的 Physical Streaming Replication 就是 Primary 將 WAL 傳給 Standbys 的架構。Standby 可以提供唯讀查詢;只有在被提升為 Primary 後,才接手這份資料的寫入。多個 PostgreSQL 執行個體不代表同一份資料有多個可寫 Leader。PostgreSQL Streaming Replication
Synchronous 與 Asynchronous Replication(同步與非同步複製):這個分類描述 Client 收到寫入成功前,系統是否等待其他 Replica 的確認,與 Single-leader/Multi-leader 描述的寫入拓樸是不同面向。
| 複製方式 | 回覆寫入成功的時機 | 延遲與可用性 | 故障與讀取的影響 |
|---|---|---|---|
| Synchronous(Sync) | 等待指定數量的 Replica 達到設定的確認階段 | 增加網路往返與副本處理時間;所需副本無法回應時,提交可能阻塞 | 降低已確認寫入在 Failover 時遺失的風險,但仍取決於確認階段與被提升的副本 |
| Asynchronous(Async) | 不等待遠端副本確認即可回覆,再由複製程序傳送變更 | 較少受遠端延遲影響,寫入可繼續進行 | Replica 可能回傳舊資料;若 Primary 故障且未複製的資料無法取回,提升落後的 Standby 可能遺失已確認寫入 |
Synchronous、Asynchronous 與 Semi-Synchronous Replication:在 Leader-Based Replication 中,如果所有 Follower 都採用 Synchronous Replication,Leader 就必須等待必要的 Follower 完成確認後,才能向 Client 回報寫入成功。當 Nodes 分布在不同地理區域時,Network Latency 與各節點處理速度可能不同,導致寫入延遲受到最慢 Follower 影響。因此,實務上可以採用 Semi-Synchronous Replication,只要求部分 Follower 同步確認,其餘 Follower 使用 Asynchronous Replication,以降低寫入延遲,同時保留一定程度的資料持久性保障。
Replication Log(複製日誌):Leader 可以透過不同形式的 Log 將資料變更傳送給 Follower。Physical Replication 可以使用 WAL(Write-Ahead Log),記錄儲存層級的變更,使 Follower 重現 Leader 的資料狀態。這類方式與 Storage Engine 的內部資料格式密切相關,因此可能限制 Leader 與 Follower 使用不同的資料庫版本。相較之下,Logical Replication 使用 Logical Log 描述資料變更,例如 Row-Level INSERT、UPDATE、DELETE,而不依賴底層的 Disk Block 格式,因此通常具有較好的版本相容性,也適合應用於 Change Data Capture(CDC)、資料倉儲同步及異質系統整合。
Read-Your-Writes Consistency(讀己之寫一致性):保證使用者寫入資料後,自己後續的讀取一定能看到已完成的寫入結果或更新的版本,例如修改個人資料後重新整理,必須看到修改後的內容;而 Monotonic Reads(單調讀取) 則保證使用者後續讀取不會看到比先前更舊的資料,避免因 Replication Lag 或切換至落後的 Follower,而產生 Moving Backward in Time(時間倒退) 的現象。兩者的差別在於,Read-Your-Writes 確保讀得到「自己寫入」的資料,而 Monotonic Reads 確保不會「讀到比之前更舊」的資料。
Multi-leader 與 Concurrent Writes:如果台北與高雄的 Leader 都能修改同一筆資料,而兩邊的更新尚未互相傳達,就可能形成沒有因果先後關係的 Concurrent Writes。例如同一筆訂單在台北被改成取消、高雄被改成出貨,兩邊都先接受更新,之後複製時便需要定義如何解決衝突。依應用需求,可以採用 LWW、保留版本後合併、適用的 CRDT,或預先限制同一筆資料的寫入位置。同步傳送更新本身不會自動定義衝突合併規則;要避免衝突,還需要寫入協調或資料責任劃分。PostgreSQL 複製方案比較
Leaderless Replication
Quorum(法定人數機制):常見於 Dynamo-style 的分散式資料庫,例如 Amazon Dynamo、Apache Cassandra 與 Riak,透過設定 Replica 總數(n)、寫入確認數(w)及讀取回應數(r),在部分節點故障時仍能提供讀寫服務。Quorum 提供一定程度的容錯能力,但在 Network Partition 下,仍可能因為無法達到 Quorum 而失去可用性。當 w + r > n 時,根據鴿籠原理,Read Quorum 與 Write Quorum 必定至少有一個共同節點,有助於降低讀取舊資料的風險,但不等於保證 Strong Consistency。這類設計常見於採用 LSM Tree 的 NoSQL 資料庫(如 Cassandra),但 Quorum 屬於分散式複製與一致性機制。這裡的 Amazon Dynamo 指 2007 年論文描述的系統,與 AWS 的託管資料庫服務 Amazon DynamoDB 不同;DynamoDB 提供讀取一致性選項,並未開放使用者直接設定內部的 w、r 參數。即使滿足 Quorum 條件,仍可能因為 Last-Write-Wins(LWW)依據 Timestamp 判斷版本先後,使 Clock Skew(時鐘偏差)造成較新的寫入被較舊的寫入覆蓋,導致資料遺失;此外,Concurrent Writes(並行寫入)與特定 Timing Edge Cases(時序邊界情況)也可能破壞預期的一致性,因此 Quorum 並不等同於 Linearizability。
Sloppy Quorum 與 Hinted Handoff:傳統 Strict Quorum 在發生 Network Partition 或 Network Interruption 時,可能因為無法取得足夠數量的 Replica 回應,而導致讀寫請求失敗。為了提高 Availability,Sloppy Quorum 允許系統暫時將資料寫入非原先指定的 Replica。例如原本資料儲存在 A、B、C,但 C 因網路問題無法連線,系統便可以暫時將資料寫入 A、B、D。當網路恢復後,再透過 Hinted Handoff 將 D 暫存的資料交還給 C。這種機制能夠提高故障期間的寫入可用性,但由於讀寫 Quorum 不一定存在交集,因此可能降低 Consistency,導致暫時性的 Stale Reads。
DDIA 書中對 Sloppy Quorum 的預設行為比較是:Cassandra 預設停用,Riak 預設啟用。這裡指的是 Sloppy Quorum,不是 Hinted Handoff;依 Cassandra 官方文件,hinted_handoff_enabled 預設為 true。Cassandra 在 QUORUM/LOCAL_QUORUM 下仍需取得指定 Replica 的足夠回應,儲存 hint 不等於取得一個 Replica 的寫入確認。
參考:Cassandra Hints 官方文件、Riak KV 技術概述。
Monitoring Staleness(監控資料過期程度):在 Leader-based Replication 中,可以透過 Leader 的寫入順序或 Replication Log Position 追蹤 Follower 的 Replication Lag,因為 Leader 提供了明確的資料更新順序;但在 Leaderless Replication 中,沒有單一權威節點,資料可能分散在不同 Replica,因此難以直接判斷哪個 Replica 持有最新且正確的資料,也不容易衡量資料落後的程度。若系統僅依賴 Read Repair,卻沒有 Anti-Entropy 等背景修復機制,長期未被讀取的資料可能永遠不會觸發修復,使某些 Replica 持續保留過期版本。因此,缺乏背景修復不僅會增加 Stale Data 長期存在的風險,也會使 Eventual Consistency 缺乏可靠的收斂保障。這也是 Leaderless Replication 在監控資料一致性與修復副本方面,比 Leader-based Replication 更具挑戰性的原因。
Concurrent Writes Solution
Concurrent Writes 與 Last Write Wins(LWW):在資料產生 Concurrent Writes 衝突時,可以使用 Last Write Wins(LWW)機制來解決此問題。當多個 Client 同時更新相同資料時,系統透過 Timestamp 選擇其中一個版本,並捨棄其他版本,使 Replica 最終收斂。然而,LWW 可能導致已成功確認的寫入遭到覆蓋,因此不適合無法容忍資料遺失的應用場景。Cassandra 採用 LWW 作為一般寫入衝突的解決機制。為避免 Lost Updates,可以使用 UUID 為每次寫入建立唯一且不可變的紀錄,避免不同操作更新相同的 Key。
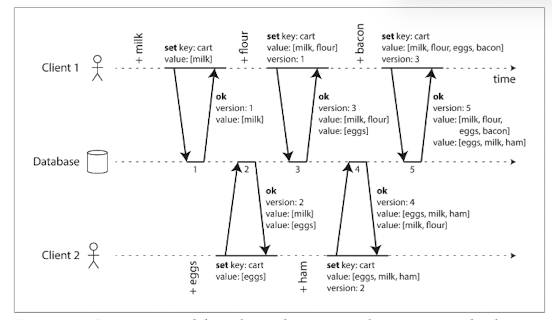
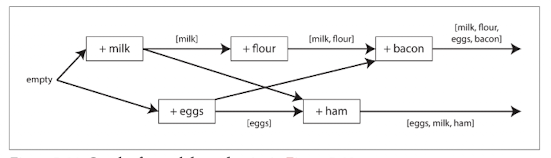
Version Numbers 與 Siblings:為了避免 LWW 可能造成的 Lost Updates,Server 會為每次寫入分配 Version Number,並利用版本資訊追蹤 Causal Dependencies(因果依賴)。當 Client 寫入資料時,必須攜帶先前讀取取得的 Version Number,讓 Server 判斷新寫入與既有版本之間的關係。 如果新寫入已經包含舊版本的資訊,Server 就可以覆蓋舊版本;但如果兩個寫入屬於 Concurrent Writes,Server 就會將它們保留為 Siblings(並行版本),避免直接覆蓋而造成資料遺失。 最後,Client 需要根據 Application Logic(應用程式邏輯),將多個 Siblings 進行 Merging(合併),並將合併後的結果與版本資訊寫回 Server。 然而,這種方式增加了 Client 的處理負擔,而且單純使用 Union 合併可能使已刪除的資料重新出現,因此需要 Tombstone(刪除標記)處理刪除操作。此外,也可以透過 CRDT 自動處理特定類型的並行更新,降低應用程式自行合併資料的複雜度。
版本更新與 Siblings 保留流程:
寫入之間的因果依賴:
Version Vectors(版本向量):前面介紹的 Version Numbers 主要用於單一 Replica 的情況,但在 Leaderless Replication 中,多個 Replica 可以同時接受寫入,因此單一版本號不足以追蹤所有寫入之間的 Causal Dependencies。Version Vectors 透過為每個 Replica 維護獨立的版本計數器,記錄不同 Replica 的版本進度,使系統能判斷新寫入是否包含既有版本的因果歷史,或是否屬於 Concurrent Writes。如果兩個版本不存在因果先後關係,則保留為 Siblings,並由 Client 進行 Merging,避免直接覆蓋而造成 Lost Updates。
| 資料庫 | 機制 | 用途 |
|---|---|---|
| Riak KV | Vector Clocks、Dotted Version Vectors | 追蹤 Causal Dependencies,保留 Siblings |
| Amazon Dynamo(原始設計) | Vector Clocks | 偵測 Concurrent Writes,保留不同版本 |
| Project Voldemort | Vector Clocks | 偵測衝突,由 Client 合併版本 |
| Apache Cassandra | LWW(非 Version Vectors) | 透過 Timestamp 解決寫入衝突 |
Partitioning 與 Sharding
Partitioning(分區)與 Sharding(分片):透過將大量資料切分成多個 Partition,並分散至不同 Node,以分攤儲存容量與讀寫負載,提高系統的 Scalability。Partitioning 可以搭配 Leader-Based Replication,讓每個 Partition 擁有獨立的 Leader 與 Follower;然而,如果 Partitioning Strategy 導致資料或請求分布不均,就可能產生 Skew(資料或負載傾斜),使部分 Partition 成為 Hot Spot(熱點),進而形成系統的效能瓶頸。
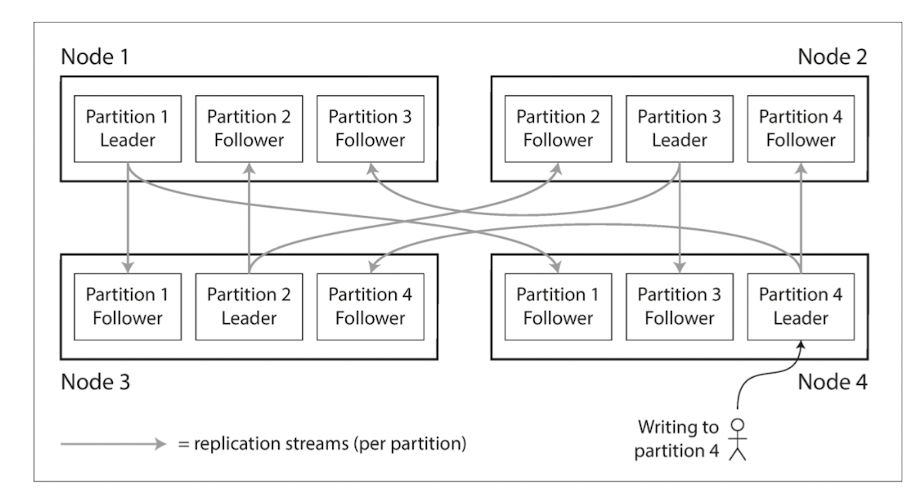
常見的 Partitioning of Key-Value Data(鍵值資料分區) 策略之一是 Partitioning by Key Range(依鍵值範圍分區),透過將連續的 Key Range 分配至不同 Partition,例如百科全書依照字母順序將 A–C、D–F 分配至不同分區。分區邊界可以手動設定,也可以由系統自動調整,例如 Bigtable、HBase、RethinkDB,以及早期 MongoDB 的 Range-Based Sharding。此外,每個 Partition 內部可以使用 SSTable、LSM Tree 或 B+ Tree 等資料結構維持 Key 的排序,使系統能有效率地執行 Range Scan(範圍掃描),例如使用 Timestamp 作為 Key,便能快速查詢特定月份的感測器資料。然而,如果大量寫入集中在最新的 Timestamp,就可能造成 Skew 與 Hot Spot,因此可以透過調整 Partition Boundary 或改善 Key Design,例如在 Timestamp 前加入 Sensor ID,來分散寫入負載,但仍須考量 Range Query 的效率。
另一種方式是 Partitioning by Hash of Key(依鍵值雜湊分區),透過 Hash Function 將 Key 轉換成 Hash Value,再依據 Hash Value 分配至不同 Partition,使資料盡可能達到 Uniformly Distributed(均勻分布),降低 Skew 與 Hot Spot 的風險。Hash Function 不一定需要具備密碼學安全性,例如 MongoDB 的 Hashed Sharding 使用 MD5,而 Cassandra 預設使用 Murmur3。然而,Hash Partitioning 會破壞原始 Key 的排序,使 Range Query(範圍查詢) 難以有效率地執行,因此 Cassandra 採用結合 Partition Key 與 Clustering Column 的方式,前者透過 Hash 決定資料分布,後者在 Partition 內維持排序,使系統能在指定 Partition Key 的情況下執行 Range Query。
此外,如果使用傳統的 hash(key) % N 分配資料,當 Cluster 新增或移除 Node 時,由於 N 發生改變,可能導致大量 Key 重新映射,產生高昂的 Data Redistribution(資料重新分配) 成本,因此可以採用 Consistent Hashing(一致性雜湊),將 Key 與 Node 映射至 Hash Ring(雜湊環),使 Node 數量變動時,通常只需要重新分配部分 Hash Range 的資料,而不必重新分配大部分資料。同時,可以透過 Virtual Nodes(虛擬節點) 讓一個 Physical Node 在 Hash Ring 上擁有多個邏輯位置,分別負責不同的 Token Range,以改善資料分布與 Cluster 擴縮容時的負載平衡,例如 Cassandra 使用 Token Ring 與 Virtual Nodes 管理資料分布,並搭配 Replication Strategy 決定 Replica 的儲存位置。
不過,即使使用 Hash Partitioning 或 Consistent Hashing,也無法完全避免 Skewed Workloads(負載傾斜) 所造成的 Hot Spot,因為相同 Key 的 Hash Value 一定相同,例如社群平台的熱門貼文可能產生大量讀寫請求,使所有流量集中在同一個 Partition。為了解決這個問題,可以採用 Key Salting(鍵值加鹽),在 Hot Key 前後加入隨機數字,例如 post_123_00 至 post_123_99,將原本集中在單一 Key 的寫入分散至多個 Key,進而分攤至不同 Partition。然而,這種方式會增加 Read Amplification(讀取放大),因為讀取時可能需要查詢多個 Key 並合併結果,因此通常只針對少數 Hot Keys 使用,同時需要額外追蹤哪些 Key 已經被拆分。
整體而言,Key Range Partitioning 著重於保留資料排序與 Range Query 效率,Hash Partitioning 著重於改善資料分布,Consistent Hashing 主要解決 Node 增減時的資料重新分配問題,而 Key Salting 則是針對相同 Key 的大量請求所造成的 Hot Spot 進行改善。
Partitioning and Secondary Indexes(分區與二級索引):當資料依照 Primary Key 進行 Partitioning 時,可以直接定位對應的 Partition,但透過 Secondary Index 查詢時,符合條件的資料可能分散在不同 Partition,因此主要有 Document-Based Partitioning(依文件分區) 與 Term-Based Partitioning(依索引詞分區) 兩種方式。前者讓每個 Partition 維護自己的 Local Index(本地索引),寫入時只需要更新資料所在的 Partition,但讀取時可能需要透過 Scatter/Gather 查詢多個 Partition 並合併結果,例如 MongoDB 與 Elasticsearch;後者則根據 Index Term 分配索引資料,形成 Global Index(全域索引),可以減少索引查詢時需要存取的 Partition 數量,但寫入時可能涉及跨 Partition 更新索引,增加 Write Amplification、Network I/O 與一致性維護成本,例如 DynamoDB 的 Global Secondary Index。整體而言,Document-Based 通常有較簡單的索引維護流程,而 Term-Based 能改善特定索引查詢的效率,但實際效能仍取決於 Workload、資料分布與查詢模式。